So untersuchen Sie technische SEO-Probleme
Status und Indexierbarkeit untersuchen
Beginnen Sie mit den für Kunden wichtigen URLs: wichtige Landingpages, Produktseiten und repräsentative Vorlagen. Erfassen, ob das Ziel Crawlability, Indexierung, Content-Qualität oder Seitenleistung ist.
Einen festen Satz an Crawl-Einstellungen und ein ausdrücklich festgelegtes Seitenlimit verwenden. Ein vorzeitig abgebrochener Crawl kann nicht belegen, dass jede Seite der Website fehlerfrei ist.
Halten Sie einen datierten Nachweis des Ziels, der Rendering-Auswahl und des Erfassungswegs fest. So lassen sich spätere Vergleiche nachvollziehen, statt Ergebnisse zu vermischen, die unter unterschiedlichen Bedingungen erfasst wurden.
Die HTTP-Antwort überprüfen, bevor der Seiteninhalt gelesen wird. Eine Weiterleitung, eine Fehlerantwort oder eine blockierte Anfrage erfordert eine andere Untersuchung als eine erfolgreich geladene HTML-Seite.
Interne Links prüfen
Prüfen Sie die Robots-Meta-Tags und Canonical-URLs im zurückgegebenen Dokument. Eine noindex-Anweisung schließt eine Seite gezielt aus der Suche aus, während ein Canonical eine bevorzugte URL angibt; die beiden erfüllen unterschiedliche Zwecke.
Repräsentative Seiten manuell untersuchen, wenn eine Vorlage auf vielen URLs dasselbe Problem verursacht. Die Vorlage zu korrigieren kann effektiver sein, als jede gerenderte Seite einzeln zu bearbeiten.
Gruppieren Sie fehlerhafte Links nach verweisender Seite und Ziel. Priorisieren Sie Links, die Nutzer oder Crawler daran hindern, wichtige Inhalte zu erreichen.
Vergleichen Sie interne Zielseiten mit der bevorzugten URL-Auswahl. Verlinken Sie direkt auf kanonische Seiten, anstatt sich auf eine Weiterleitungskette zu verlassen.
Metadaten und Duplikate prüfen
Eine fehlende Seite in einem Crawl mit begrenztem Umfang kann außerhalb des Crawl-Bereichs liegen. Überprüfen Sie die URL unabhängig, bevor Sie sie als verwaist oder gelöscht einstufen.
- On-Page-Qualität – Inhalte, die die Anfrage korrekt beantworten
- Kombinieren Sie die On-Page API mit ergänzenden Datensätzen, wenn Ihre Fragestellung Suchsichtbarkeit, Nachfrage, Links, Seitengesundheit oder KI-Zitate umfasst.
Rendering- und Leistungstests auswählen
Korrekturen priorisieren und verifizieren
Achten Sie auf Titel und Beschreibungen, die den Zweck jeder Seite genau benennen. Dieselbe allgemeine Aussage auf jeder Produktseite hilft Nutzern nicht, die Produkte voneinander zu unterscheiden.
Vergleichen Sie mögliche Duplikate anhand ihrer Hauptinhalte und Suchintention. Entscheiden Sie, ob Sie sie zusammenführen, eine nicht mehr benötigte Route weiterleiten oder tatsächlich eigenständige Informationen erstellen möchten.
Dieselbe bevorzugte URL verwenden in internen Links, Canonical-Tags und Sitemap. Widersprüchliche Signale erschweren die Ermittlung der beabsichtigten URL.
Prüfungsumfang festlegen
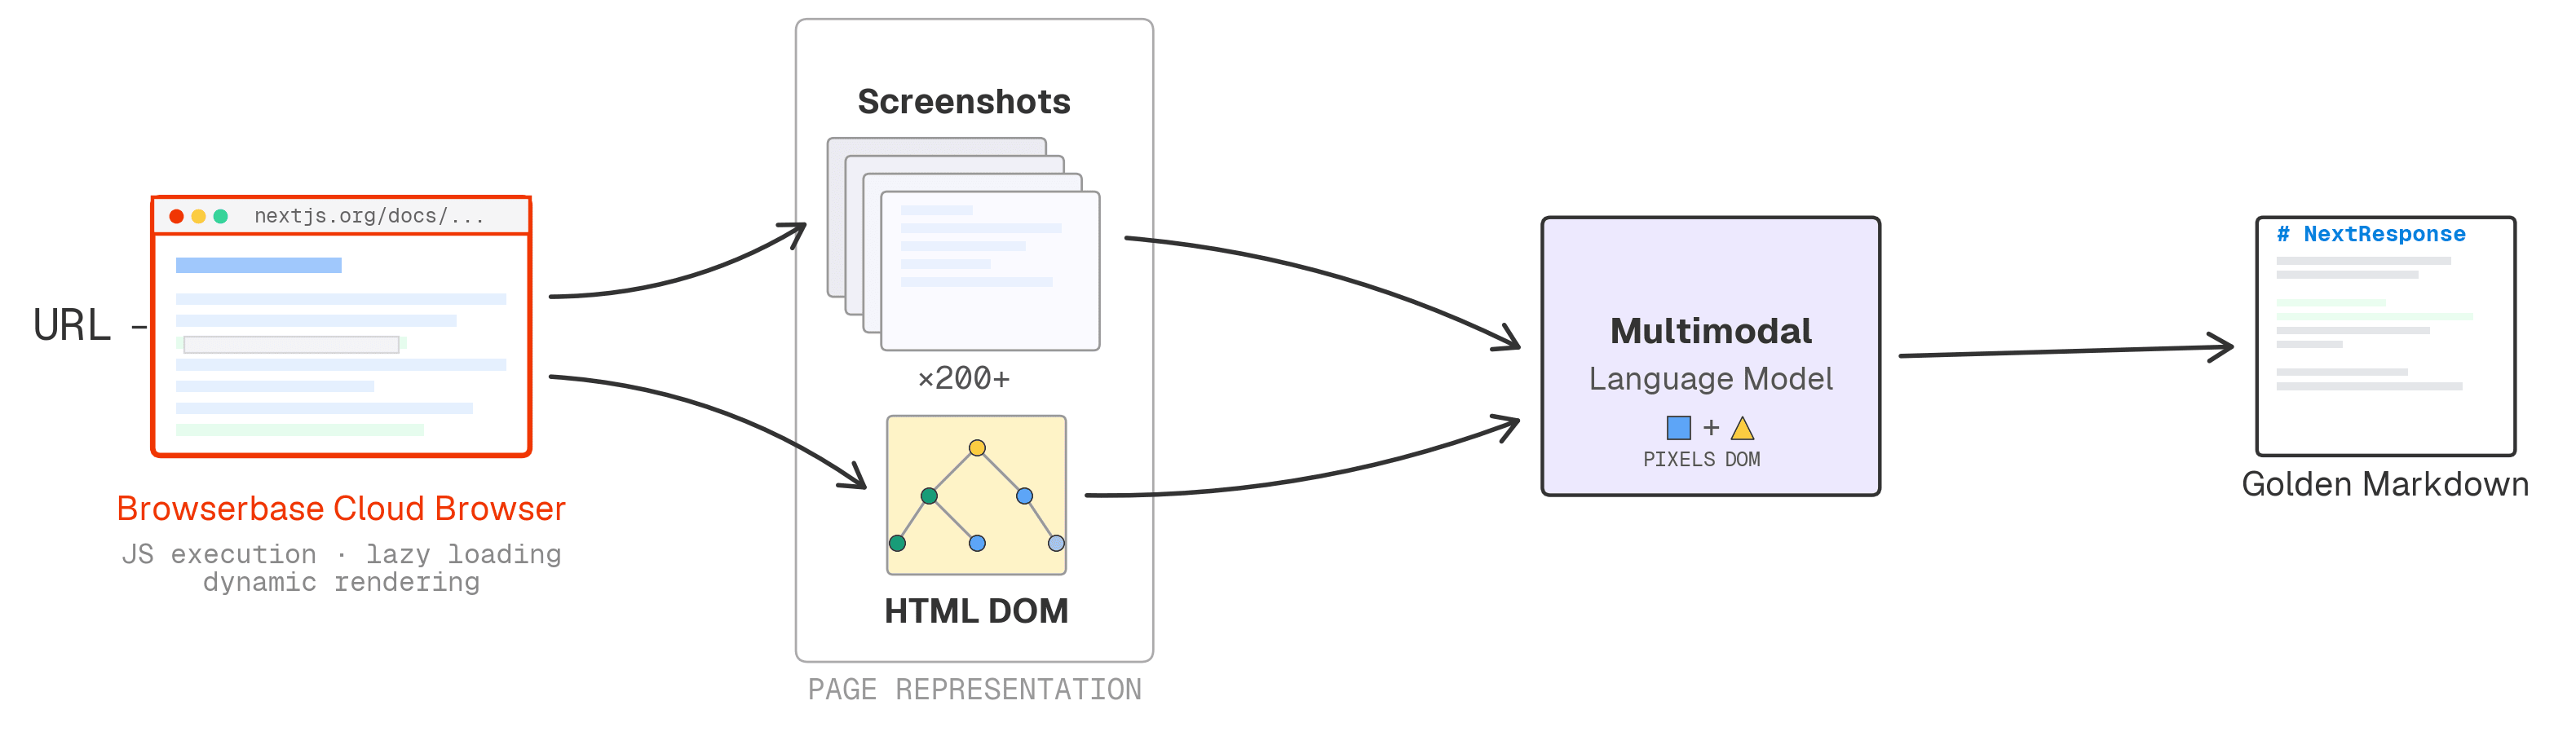
Beginnen Sie mit der einfachsten Erfassung, die die benötigten Inhalte liefert. JavaScript-abhängige Vorlagen erfordern möglicherweise einen Browser, doch die browserbasierte Erfassung stellt andere Ressourcenanforderungen.
- korrekt abrufen, aber die Formatierung beschädigen
- die Struktur perfekt beibehalten, dabei aber die Hälfte der Seite weglassen
Interpretieren Sie Lighthouse als Labortest unter bestimmten Bedingungen. Geben Sie das Ergebnis nicht als Core Web Vitals echter Nutzer aus, solange keine Felddaten vorliegen.
- Legen Sie das Keyword, die Suchmaschine, den Standort, die Sprache und das Gerät fest. Behalten Sie diese Einstellungen bei jeder Beobachtung bei, damit Rankingvergleiche dieselbe Zielgruppe und denselben Markt abbilden.
- Organische Suche, Maps, Nachrichten, Bilder, Shopping und weitere unterstützte Ergebnistypen recherchieren. Elementtypen verwenden, um die von jedem Endpunkt zurückgegebenen Felder zu interpretieren.
Status und Indexierbarkeit untersuchen
Prüfen Sie bei der Untersuchung von Ladeproblemen Bilder, Schriftarten und Ressourcen von Drittanbietern. Testen Sie dieselbe Seite anschließend unter vergleichbaren Bedingungen erneut. eine Ressource ändern.
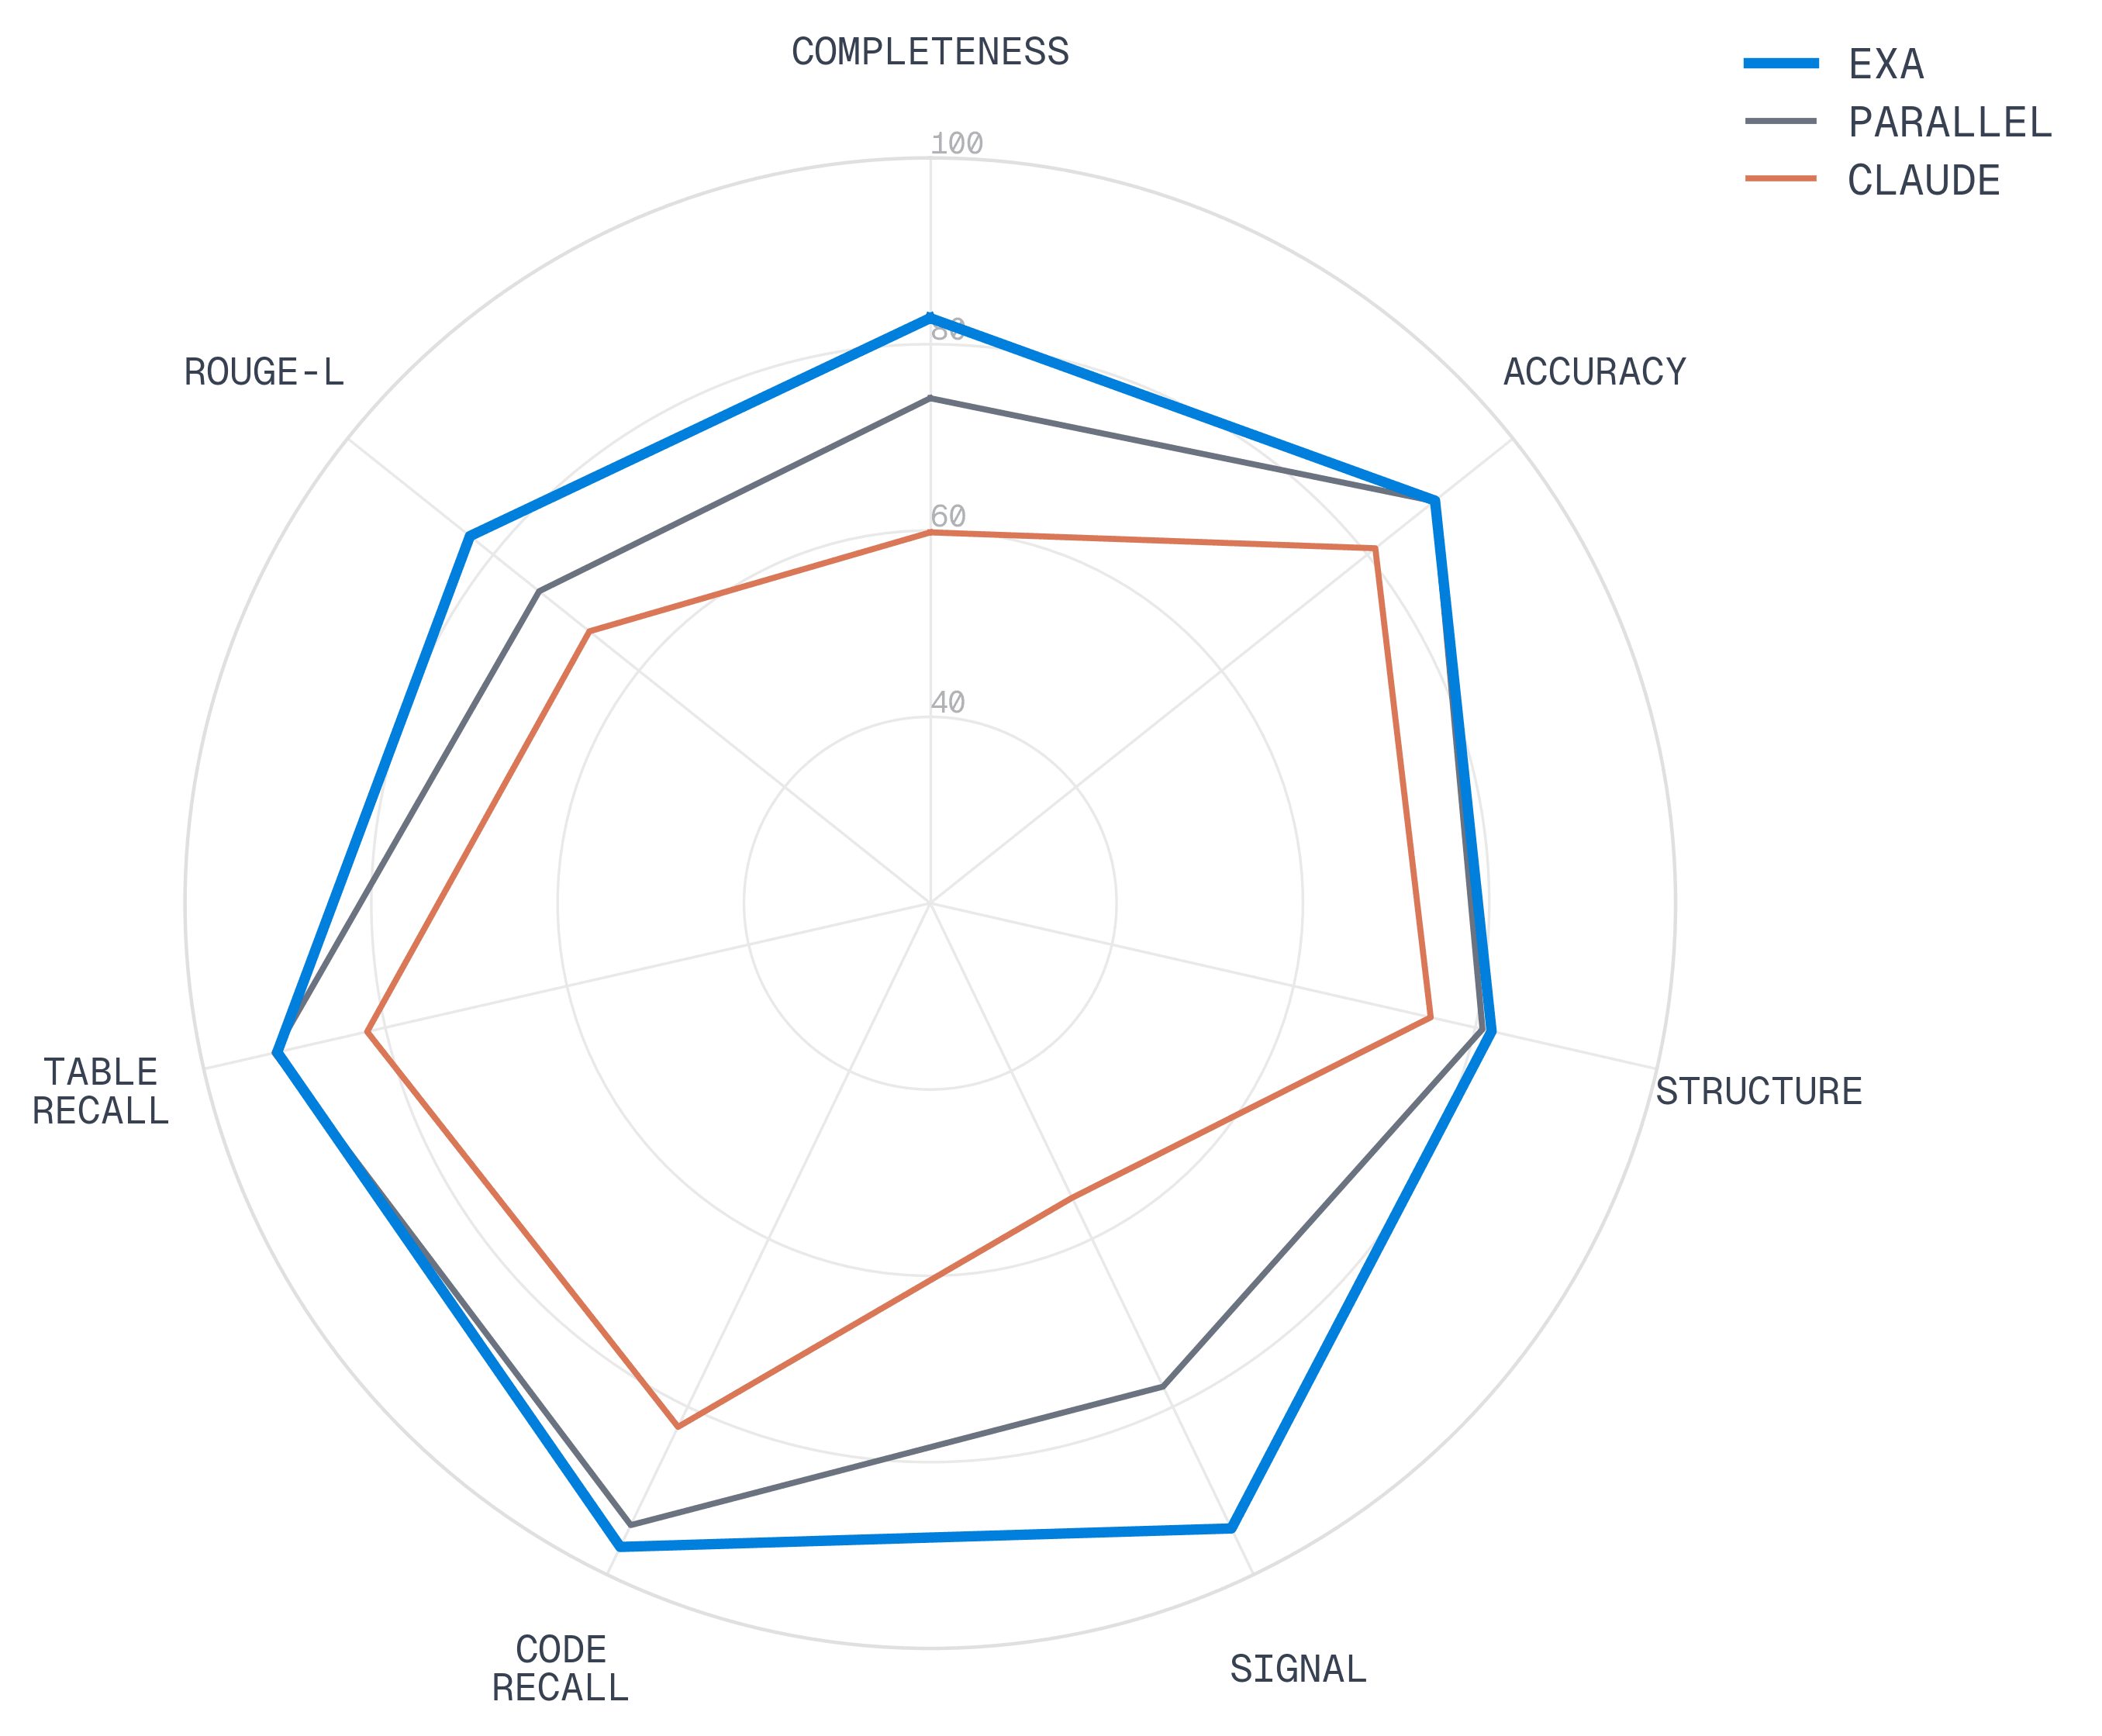
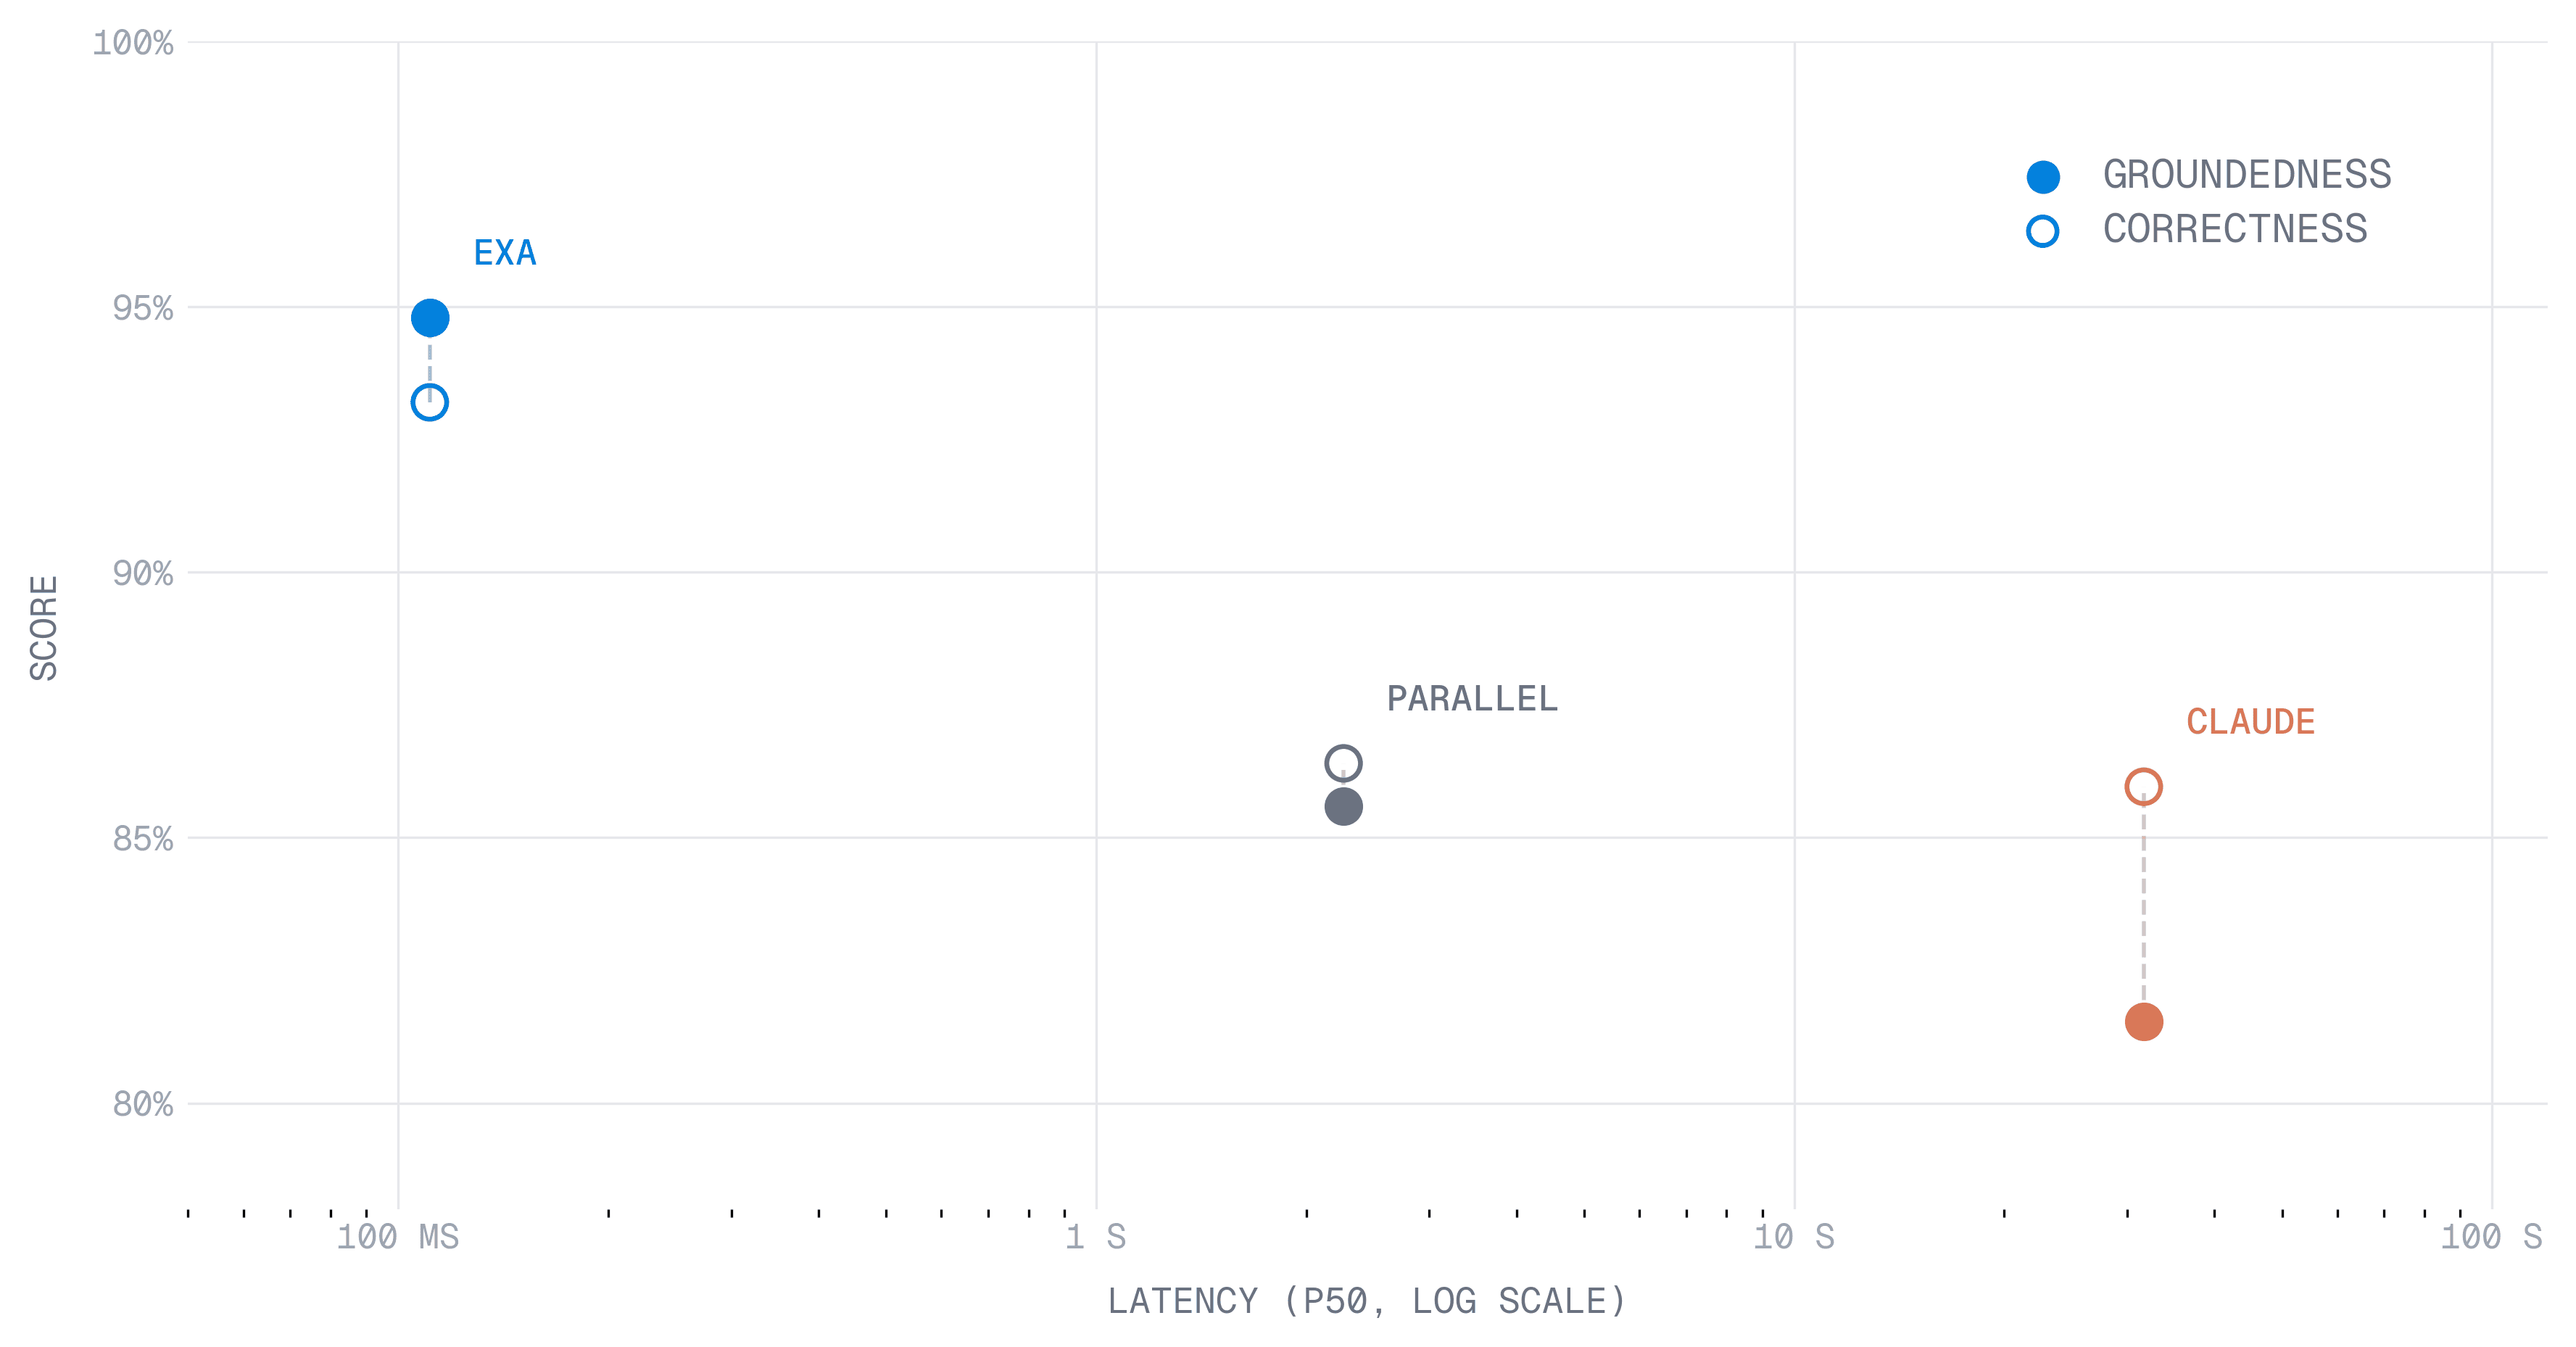
| Anbieter | Vollständigkeit | Signal | Struktur | Genauigkeit | Code Recall | Tabellenabruf | ROUGE-L |
|---|---|---|---|---|---|---|---|
| DataSEO | 82.8 | 94.5 | 81.8 | 89.3 | 96.7 | 91.9 | 83.2 |
| Beispielsammlung | 74.2 | 77.6 | 80.8 | 89.2 | 94.1 | 92.2 | 73.7 |
| Claude† | 59.8 | 55.1 | 75.1 | 81.1 | 82.4 | 82.0 | 66.8 |
Halte für jeden Befund die betroffene URL, die Belege, die wahrscheinlichen Auswirkungen auf Nutzer und eine konkrete Lösung fest. Unterscheide bestätigte Probleme von Fragen, die noch untersucht werden müssen.
Interne Links prüfen
Behebe Probleme bei der direkten Indexierung und Navigation, bevor du den Feinschliff vornimmst geringfügige Metadaten. Sortieren Sie die Priorisieren Sie die verbleibenden Aufgaben nach geschäftlicher Bedeutung, Wirkung und Implementierungsaufwand.
Metadaten und Duplikate prüfen
Die relevanten Prüfungen nach einer Fehlerbehebung wiederholen und die Belege vergleichen. Ein erfolgreicher Test bestätigt das geprüfte Verhalten; er garantiert keine künftige Suchmaschinenplatzierung.
Checkliste: Beginnen Sie mit den für Kunden wichtigen URLs: zentrale Landingpages, Produktseiten und repräsentative Vorlagen. Halten Sie fest, ob es um Crawlbarkeit, Indexierung, Content-Qualität oder Seitenleistung geht.
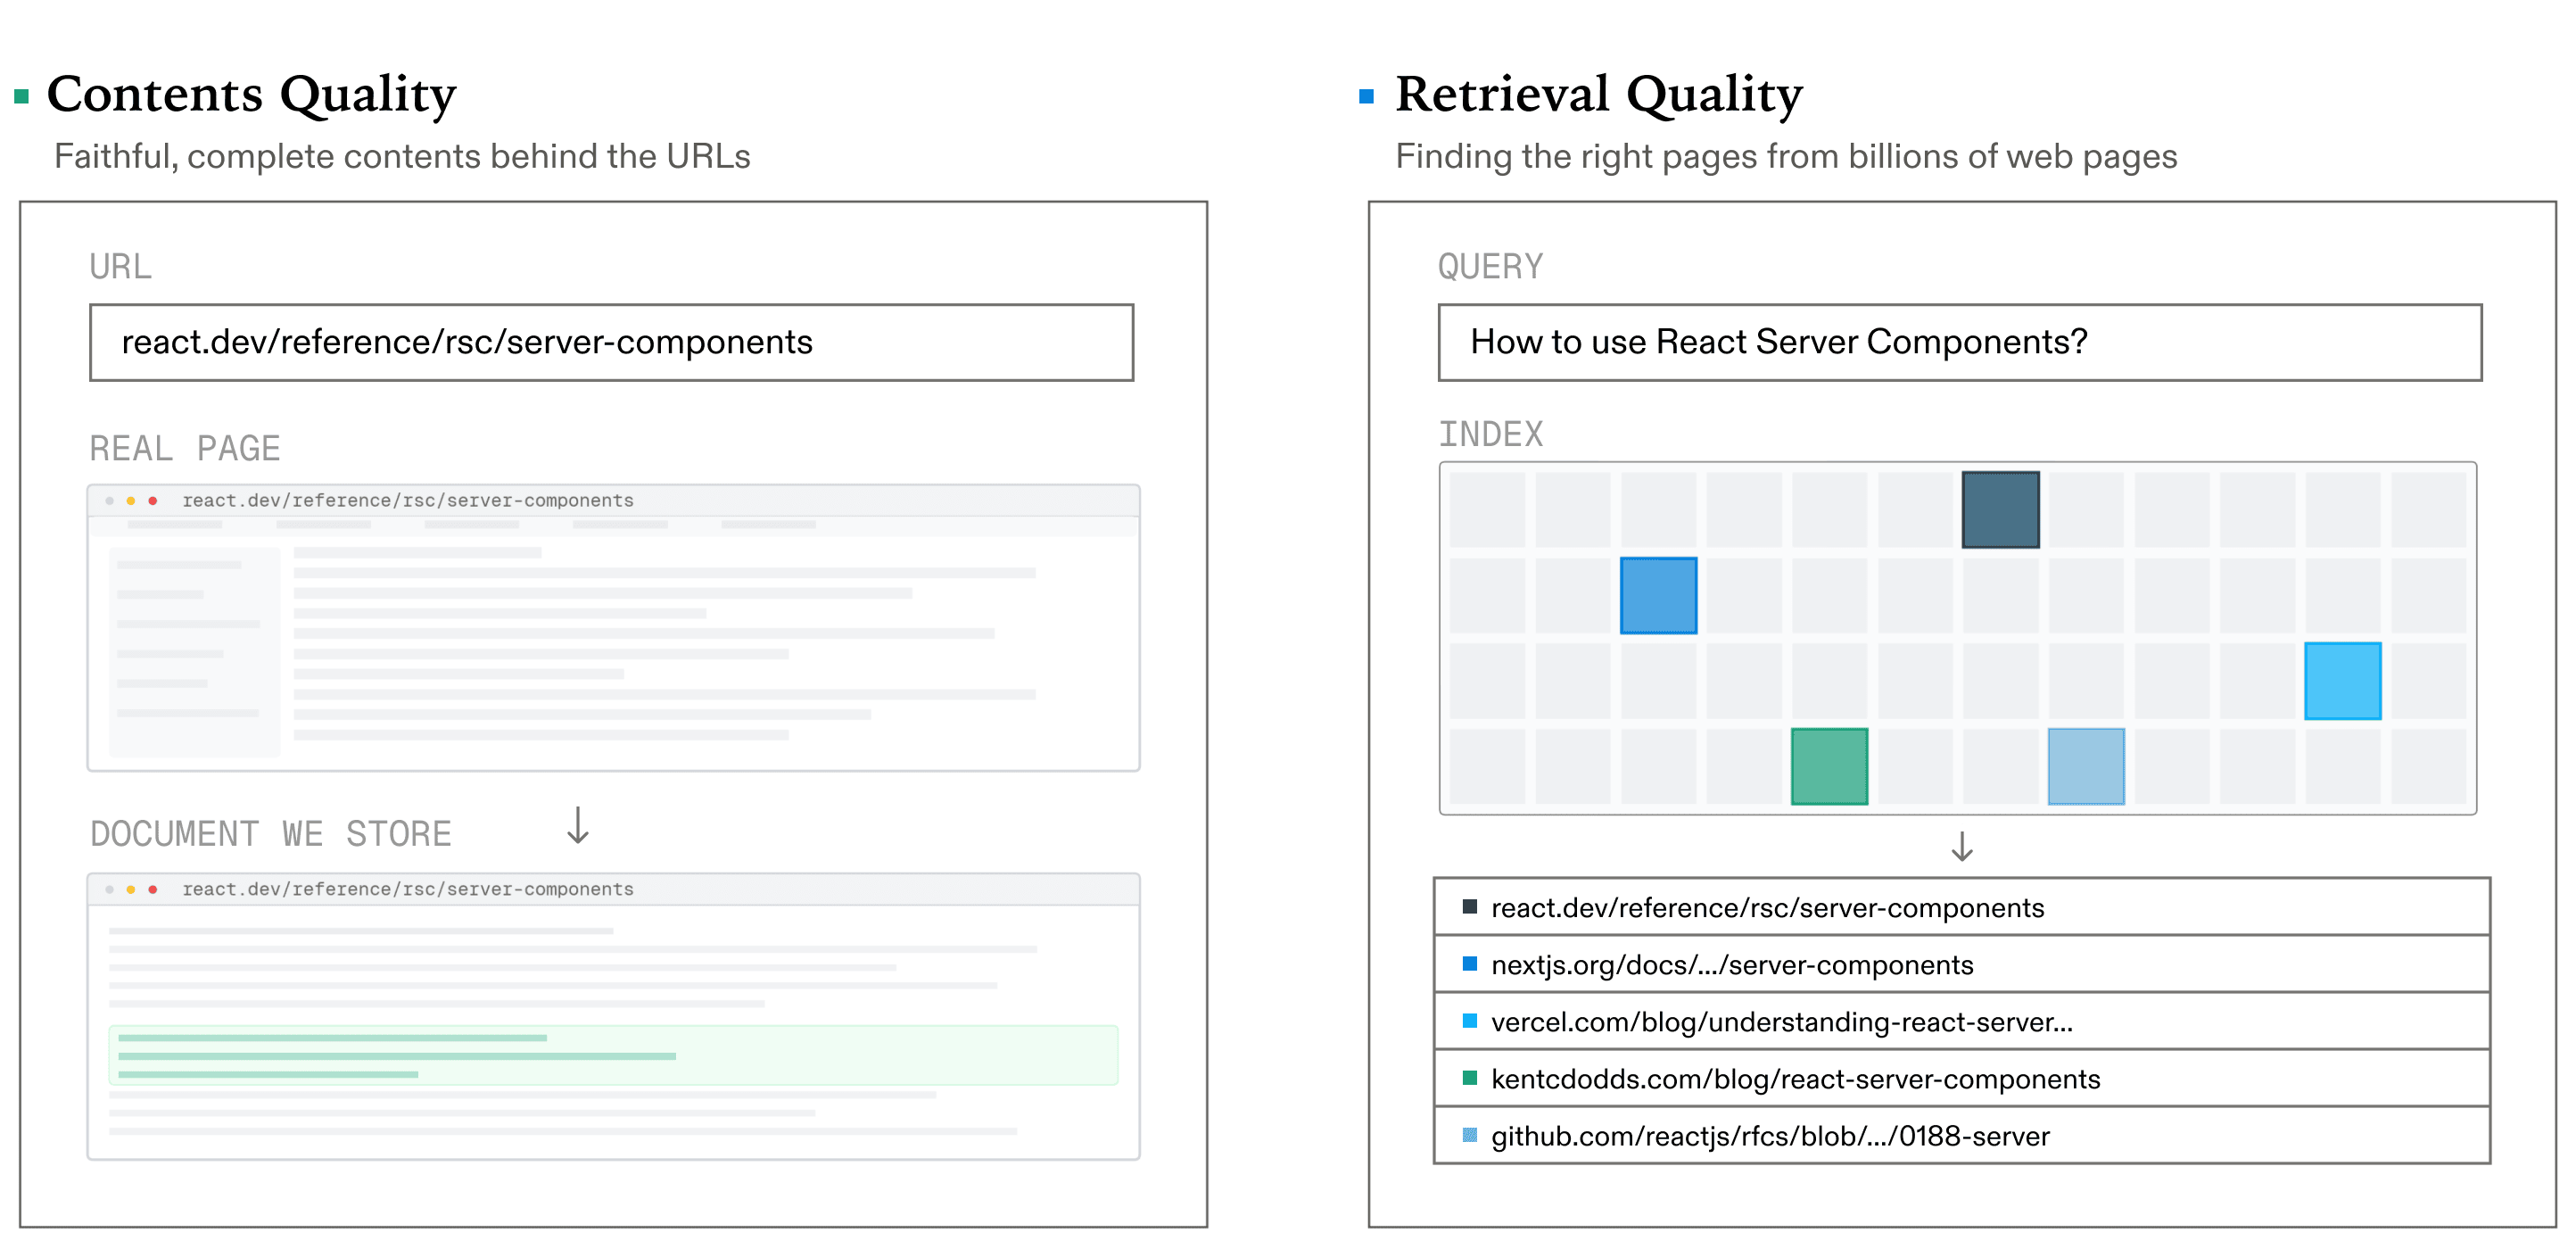
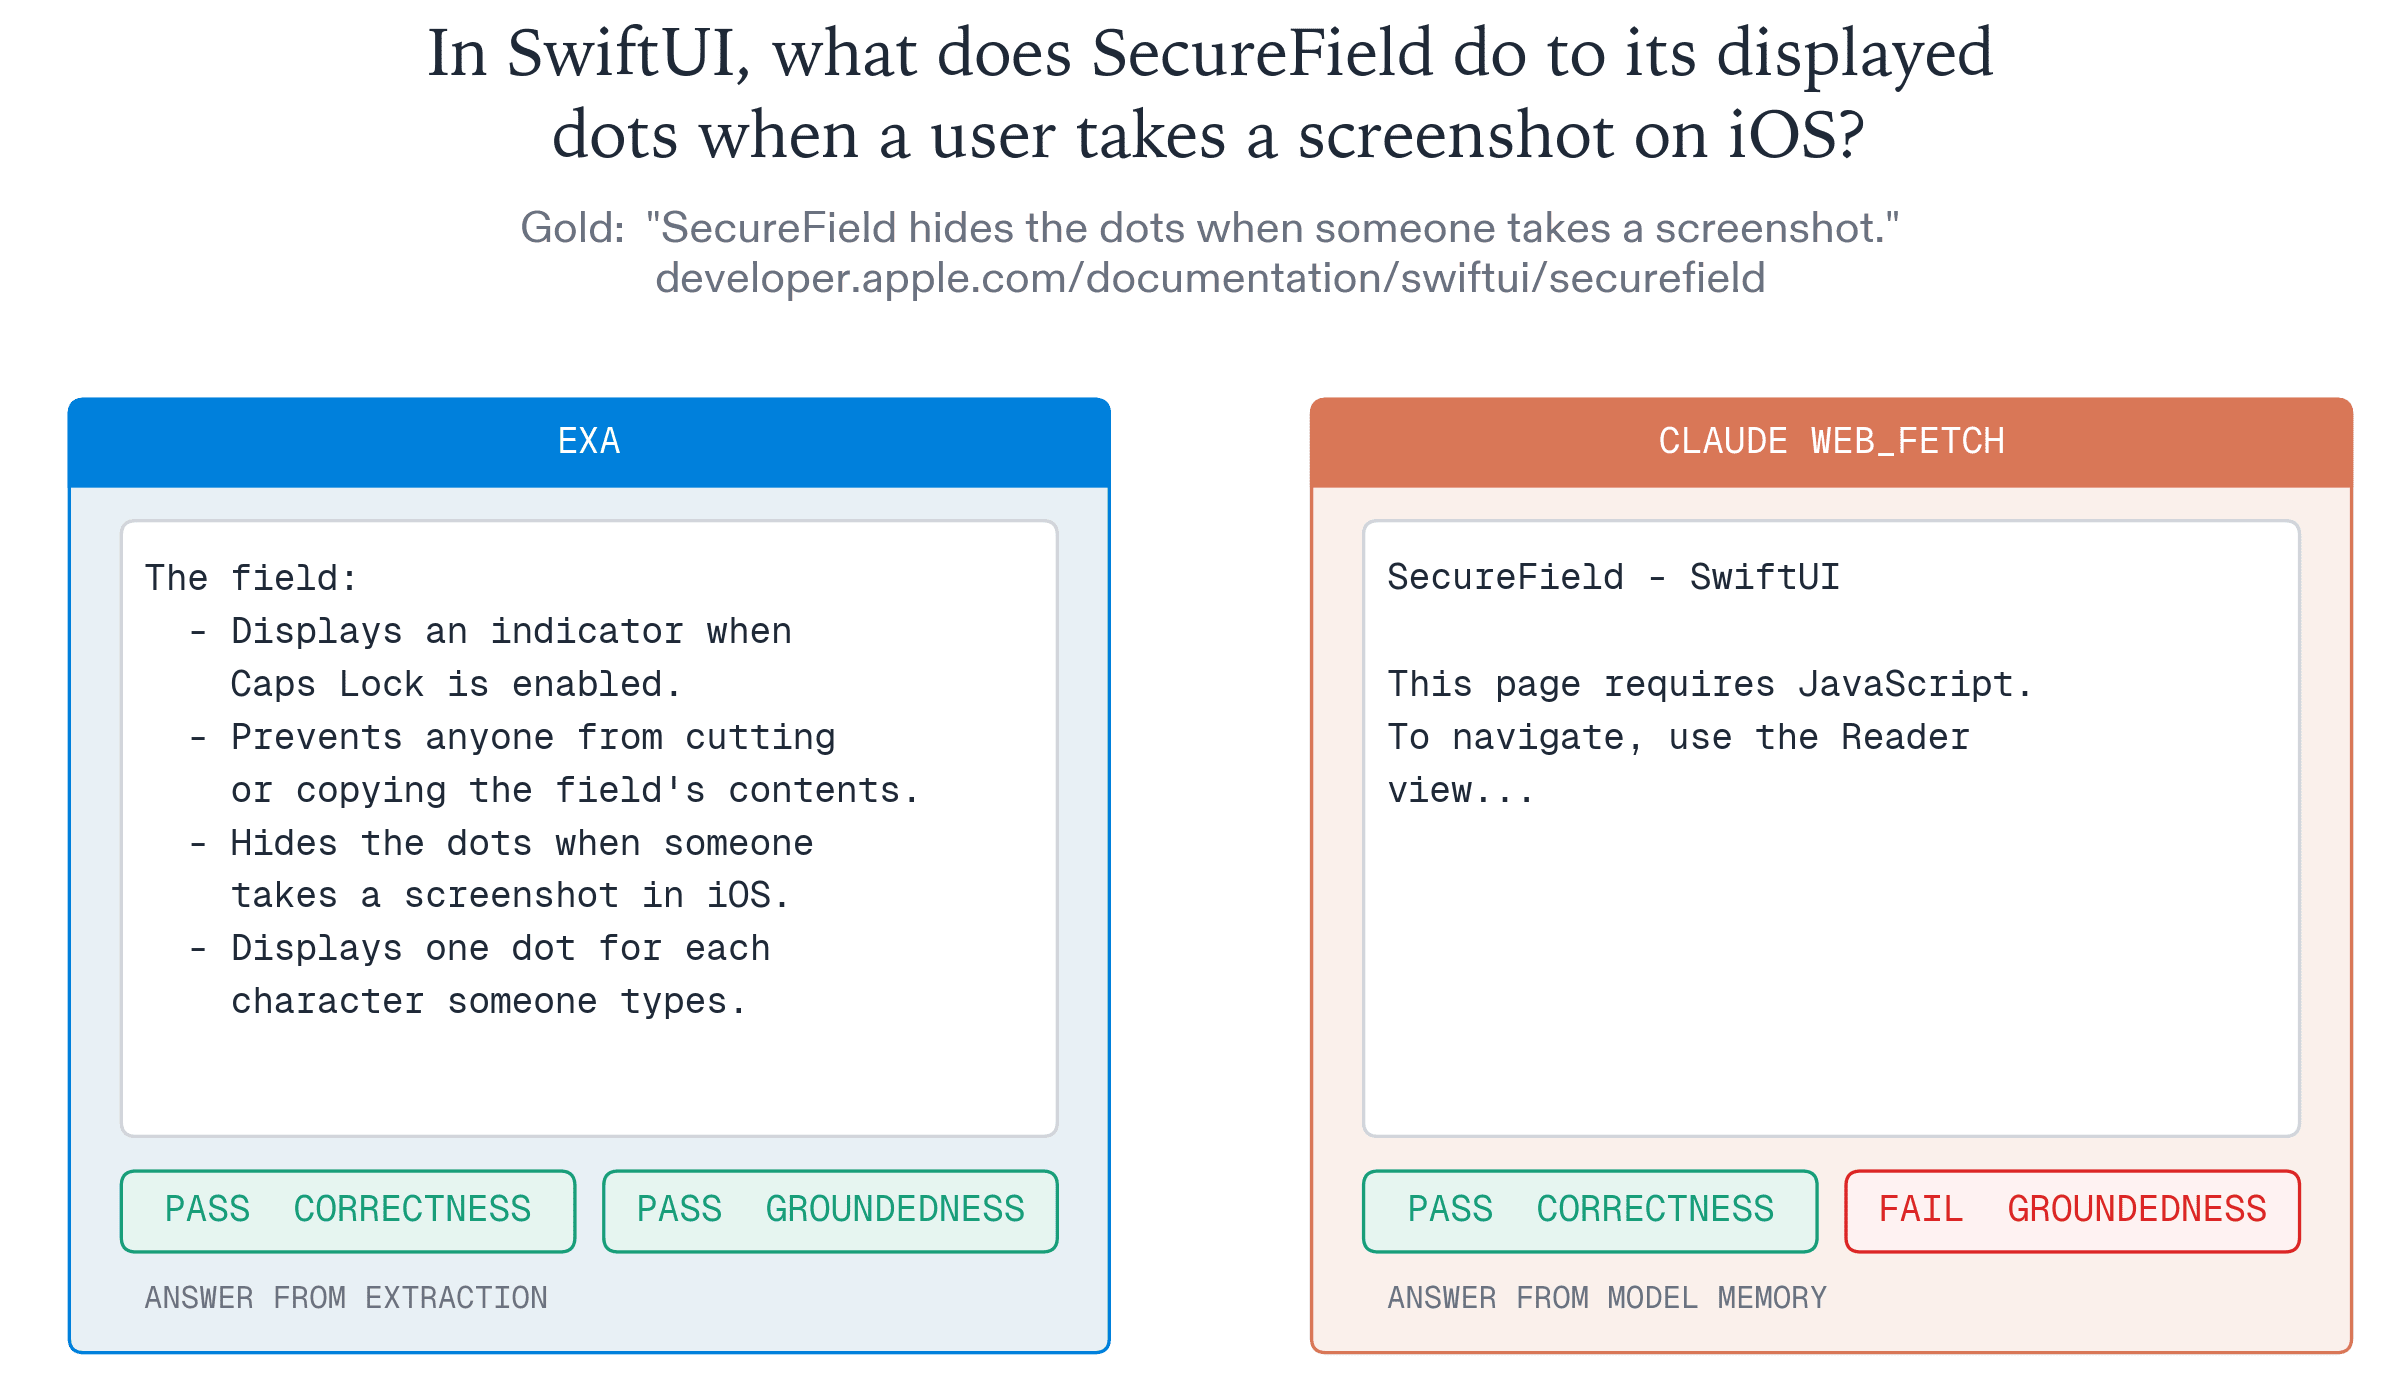
- Die Highlights waren falsch, aber das Synthese-LLM gab die richtige Antwort zurück
- Die Highlights waren korrekt, aber das Synthese-LLM gab eine falsche Antwort zurück
Checkliste: Verwenden Sie feste Crawling-Einstellungen und ein explizites Seitenlimit. Ein Crawl, der vorzeitig abbricht, kann nicht bestätigen, dass alle Seiten der Website fehlerfrei sind.
Checkliste: Führen Sie eine datierte Aufzeichnung des Ziels, Rendering Auswahl und Erfassungsroute. Dadurch lässt sich ein späterer Vergleich nachvollziehen, statt Ergebnisse zu vermischen, die unter unterschiedlichen Bedingungen erfasst wurden.
- Beginnen Sie mit den Zielen und Märkten, die Sie untersuchen möchten. Speichern Sie Quelle und Erfassungszeitpunkt mit jeder Antwort der On-Page API.
- Kombinieren Sie die On-Page API mit ergänzenden Datensätzen, wenn Ihre Fragestellung Suchsichtbarkeit, Nachfrage, Links, Seitengesundheit oder KI-Zitate umfasst.
Rendering- und Leistungstests auswählen
Checkliste: Prüfen Sie die HTTP-Antwort bevor Sie den Seiteninhalt lesen. Bei einer Weiterleitung, einer Fehlerantwort oder einer blockierten Anfrage ist eine andere Untersuchung erforderlich als bei einer erfolgreich geladenen HTML-Seite.
Checkliste: robots prüfen Meta-Tags und Canonical URLs in the returned Dokument. Eine Noindex-Direktive schließt Inhalte bewusst aus der Suche aus, während eine Ein Canonical-Tag gibt eine bevorzugte URL an; sie lösen unterschiedliche Probleme.
Korrekturen priorisieren und verifizieren
Checkliste: Prüfen Sie repräsentative Seiten manuell, wenn eine Vorlage bei vielen URLs dasselbe Problem verursacht. Eine Korrektur der Vorlage kann wirksamer sein, als jede gerenderte Seite einzeln zu bearbeiten.
Checkliste: Gruppieren Sie fehlerhafte Links nach verweisender Seite und Ziel. Priorisieren Sie Links, die Nutzer oder Crawler daran hindern, wichtige Inhalte zu erreichen.
Prüfungsumfang festlegen
Status und Indexierbarkeit untersuchen
Checkliste: Vergleichen Sie interne Zielseiten mit der bevorzugten URL-Auswahl. Verlinken Sie direkt auf kanonische Seiten, statt sich auf eine Weiterleitungskette zu verlassen.
Checkliste: Eine Seite, die bei einem begrenzten Crawl fehlt, liegt möglicherweise außerhalb des Crawl-Umfangs. Überprüfen Sie die URL unabhängig, bevor Sie als verwaist oder gelöscht bezeichnen.
Checkliste: Achten Sie auf Titel und Beschreibungen, die eindeutig angeben Zweck jeder Seite. Dieselbe allgemeine Aussage auf jeder Produktseite zu wiederholen hilft Nutzern nicht unterscheiden Sie sie.
Interne Links prüfen
Checkliste: Vergleichen Sie mögliche Duplikate anhand ihrer Hauptinhalte und Suchintention. Entscheiden Sie, ob Sie sie zusammenführen, eine stillgelegte Route weiterleiten oder tatsächlich eigenständige Informationen erstellen.
Checkliste: Verwenden Sie dieselbe bevorzugte URL in internen Links, Canonical-Tags und der Sitemap. Widersprüchliche Signale erschweren die Erkennung der beabsichtigten URL.
Checkliste: Beginnen Sie mit der einfachsten Erfassungsmethode, die die benötigten Inhalte bereitstellt. Vorlagen, die von JavaScript abhängen, erfordern möglicherweise einen Browser; die Browser-Erfassung hat jedoch andere Ressourcenanforderungen.
- Gruppieren Sie Crawling-Probleme nach Typ und Priorität und prüfen Sie nach einer Behebung die betroffenen URLs.
-
Legen Sie das Keyword, die Suchmaschine, den Standort, die Sprache und das Gerät fest. Behalten Sie diese Einstellungen bei jeder Beobachtung bei, damit Rankingvergleiche dieselbe Zielgruppe und denselben Markt abbilden.
- Organische Suche, Maps, Nachrichten, Bilder, Shopping und weitere unterstützte Ergebnistypen recherchieren. Elementtypen verwenden, um die von jedem Endpunkt zurückgegebenen Felder zu interpretieren.
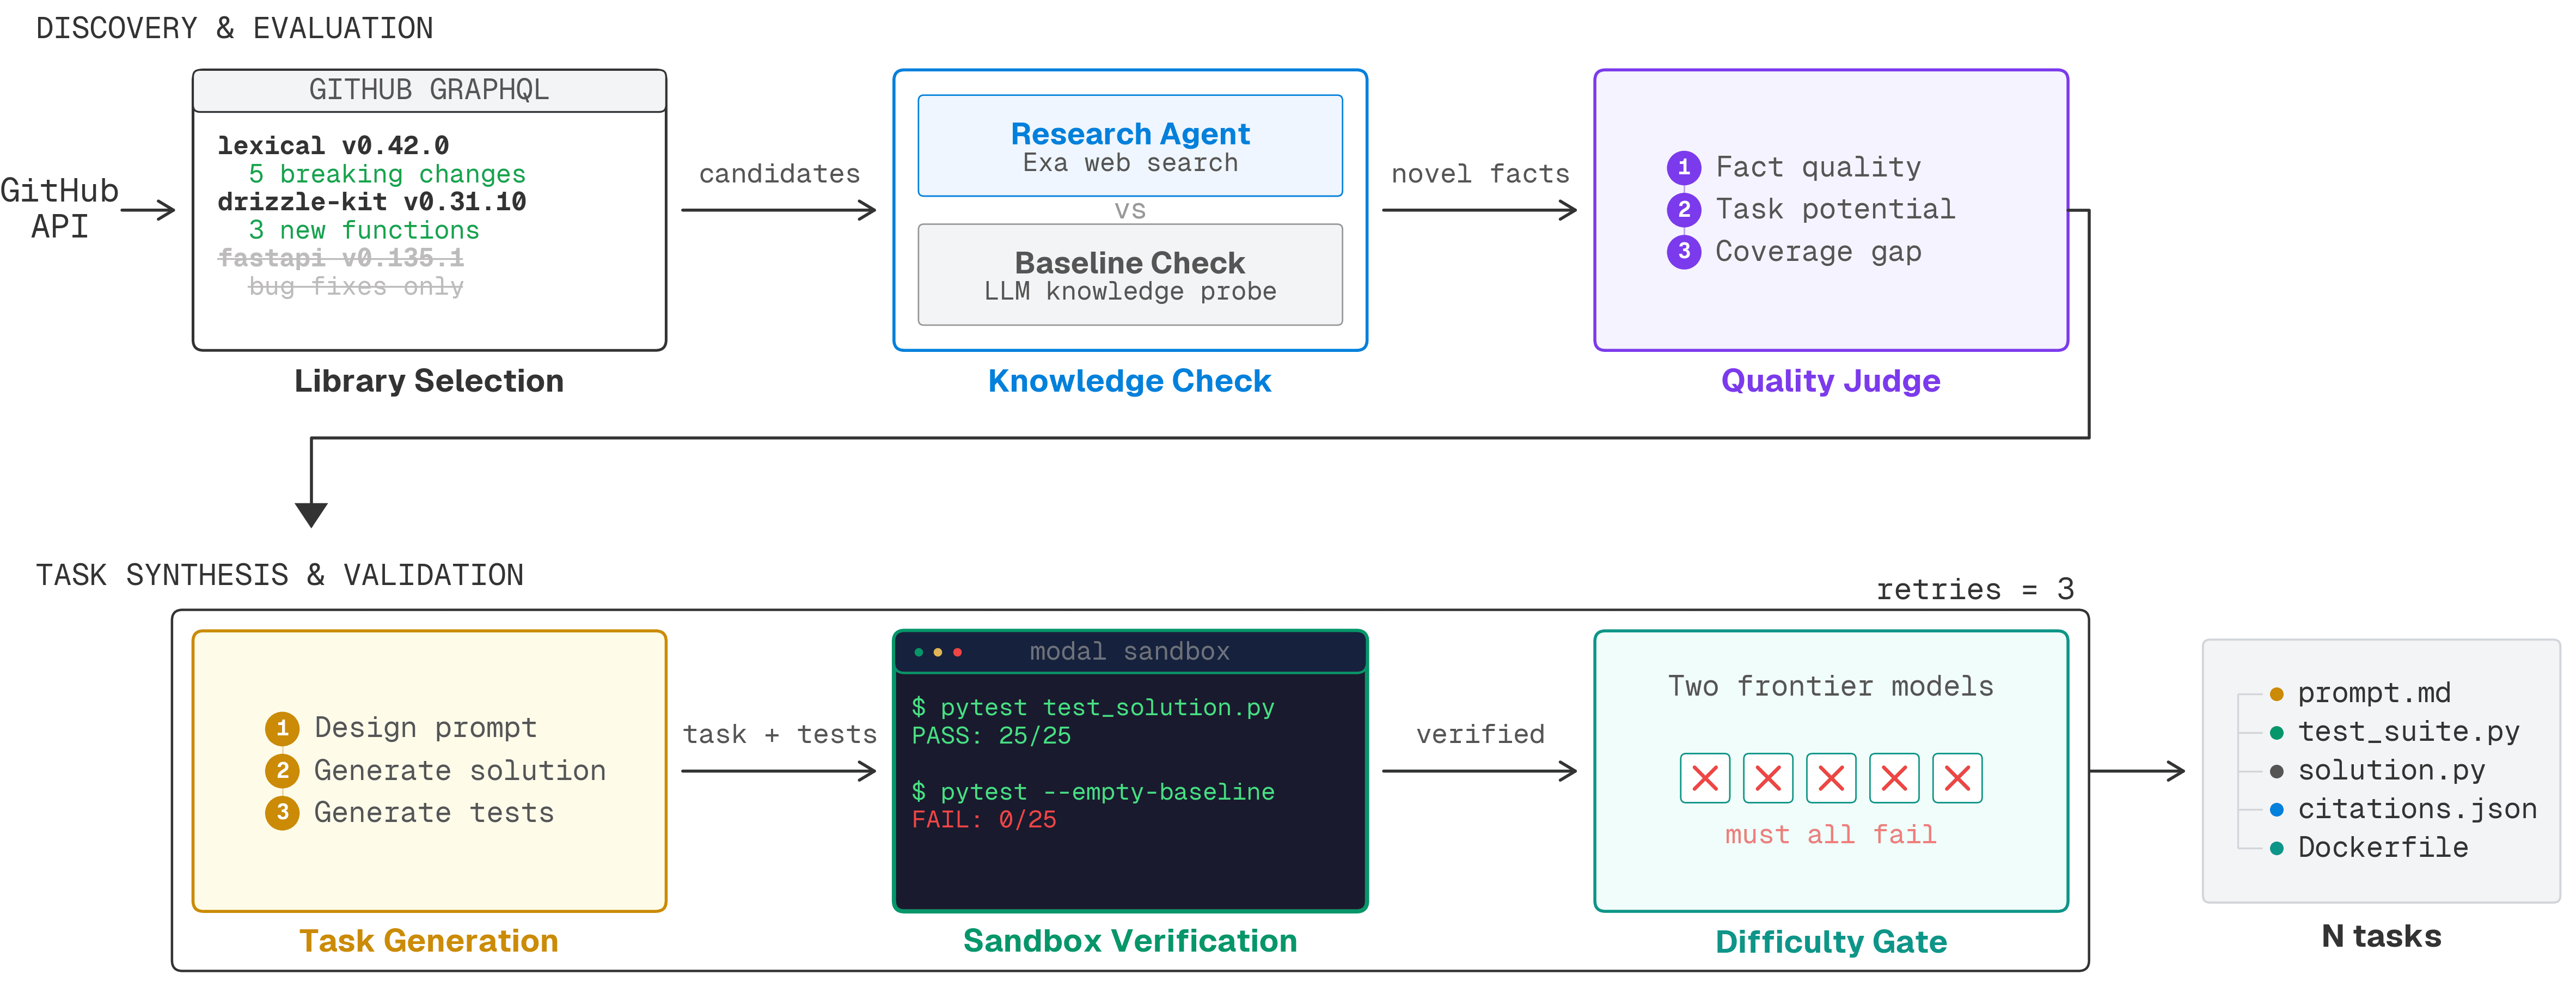
- Aufgabengenerierung: Erstellte anhand der neuartigen Fakten eine Aufgabenbeschreibung, eine Lösung und eine Testsuite
- Nein. Wählen Sie die Rendering- und Auditoptionen für die zu prüfende Website. Zusätzliche Verarbeitung kann sich auf die Erfassungskosten und die Geschwindigkeit auswirken.
- Beginnen Sie mit den Zielen und Märkten, die Sie untersuchen möchten. Speichern Sie Quelle und Erfassungszeitpunkt mit jeder Antwort der On-Page API.
Checkliste: Interpretieren Sie Lighthouse als Labortest unter bestimmten Bedingungen. Geben Sie das Ergebnis nicht als Core Web Vitals aus realen Nutzerdaten aus, wenn keine Felddaten vorliegen.
Checkliste: Prüfen Sie Bilder, Schriftarten und Ressourcen von Drittanbietern, wenn Sie Ladeprobleme untersuchen. Testen Sie dieselbe Seite nach einer Änderung an einer Ressource unter vergleichbaren Bedingungen erneut.
Metadaten und Duplikate prüfen
Checkliste: Halten Sie zu jedem Befund die betroffene URL, Belege, die wahrscheinlichen Auswirkungen auf Nutzer und eine konkrete Lösung fest. Unterscheiden Sie bestätigte Probleme von Fragen, die noch untersucht werden müssen.
Checkliste: Beheben Sie direkte Probleme mit der Indexierung und Navigation, bevor Sie kleinere Details optimieren. On-Page API entdecken → nach Geschäftsbedeutung, Auswirkungen und Implementierungsaufwand.
Checkliste: Wiederholen Sie die relevanten Prüfungen nach einer Korrektur und vergleichen Sie die Belege. Ein erfolgreicher Test bestätigt das geprüfte Verhalten, garantiert aber kein zukünftiges Suchranking.
Offene Stellen ansehen-
1
.
In der Praxis: Beginnen Sie mit den URLs, die für Kunden wichtig sind: wichtige Landingpages, Produktseiten und repräsentative Vorlagen. Halten Sie fest, ob das Ziel Crawlbarkeit ist, Indexierung, Content-Qualität oder Seitenleistung.
Prüfungsumfang festlegen
In der Praxis: Verwenden Sie feste Crawling-Einstellungen und ein explizites Seitenlimit. Ein Crawl, der vorzeitig endet, kann nicht belegen, dass alle Seiten der Website fehlerfrei sind.
Status und Indexierbarkeit untersuchen
In der Praxis: Halten Sie Ziel, Rendering-Auswahl und Erfassungsweg mit Datum fest. So lässt sich ein späterer Vergleich nachvollziehen, statt Ergebnisse zu vermischen, die unter unterschiedlichen Bedingungen erfasst wurden.
Interne Links prüfen
In der Praxis: Prüfen Sie die HTTP-Antwort, bevor Sie den Seiteninhalt lesen. Eine Weiterleitung, eine Fehlerantwort oder eine blockierte Anfrage erfordert eine andere Untersuchung als eine erfolgreiche HTML-Seite.
Metadaten und Duplikate prüfen
In der Praxis: Prüfen Sie Robots-Meta-Tags und kanonische URLs im zurückgegebenen Dokument. Eine Noindex-Anweisung schließt eine Seite absichtlich von der Suche aus, während ein Canonical eine bevorzugte URL angibt; die beiden lösen unterschiedliche Probleme.