如何调查技术 SEO 问题
检查状态和可编入索引性
从对客户重要的网址开始:关键落地页、 产品页面和代表性模板。 记录目标是可抓取性、索引、内容质量还是页面性能。
使用固定的爬取设置和明确的页面限制。提前停止的爬取无法证明网站上的每个页面都正常。
保留带日期的记录,注明目标、渲染选项和采集路由。这样,后续比较就有据可查,不会混合在不同条件下采集的结果。
查看页面内容之前,先检查 HTTP 响应。重定向、错误响应或请求被阻止,需要采用不同于成功获取 HTML 页面的调查方式。
查看内部链接
检查元数据和重复内容
受限抓取中缺失的页面可能位于抓取范围之外。将其标记为孤立页面或已删除页面之前,请单独核实该 URL。
- On-Page 质量 - 能正确回答查询的内容
- 如果您的问题涉及搜索可见度、需求、链接、页面健康度或 AI 引用,可将 On-Page API 与互补数据集结合使用。
选择渲染方式和性能测试
确定修复优先级并进行验证
选择能够准确说明各页面用途的标题和描述。在每个产品页面重复相同的通用说明,无助于用户区分它们。
根据主要内容和意图比较重复内容候选项。决定是将其整合、将已停用的路径重定向,还是创建真正独立的信息。
使用相同的首选 URL 在内部链接中, canonical 标签和站点地图。信号相互冲突,会使预期 URL 更难判断。
定义审计范围
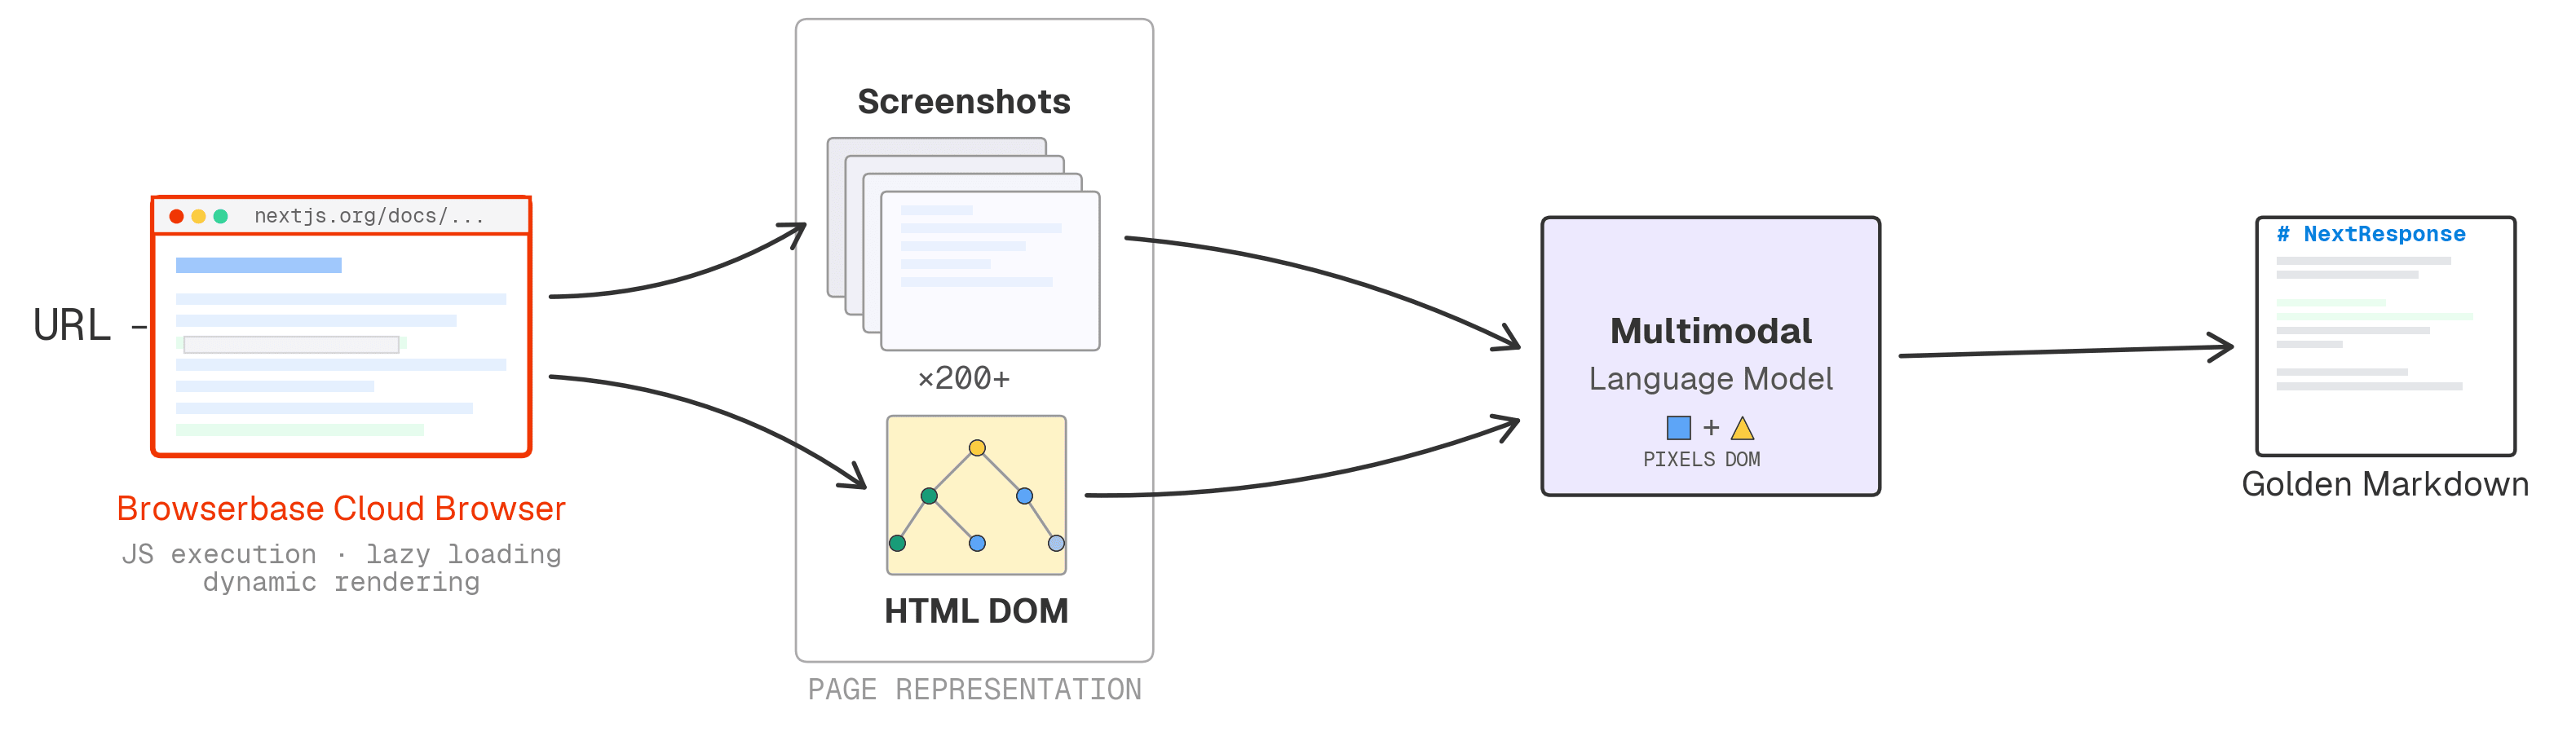
从能提供所需内容的最简单采集方式开始。依赖 JavaScript 的模板可能需要浏览器,但基于浏览器的采集有不同的资源要求。
- 正确获取但会破坏格式
- 在完美保留结构的同时删除页面的一半
Lighthouse 结果应解读为特定条件下的实验室测试结果。没有现场测量数据时,请勿将其报告为真实用户 Core Web Vitals。
- 设置关键词、搜索引擎、位置、语言和设备。保留这些设置,并用于每次观测,以便排名比较反映相同的受众和市场。
- 研究自然搜索、地图、新闻、图片、购物及其他受支持的结果类型。使用项目类型解读各端点返回的字段。
检查状态和可编入索引性
调查加载问题时,请检查图片、字体和第三方资源。在可比条件下重新测试同一页面后 更改资源。
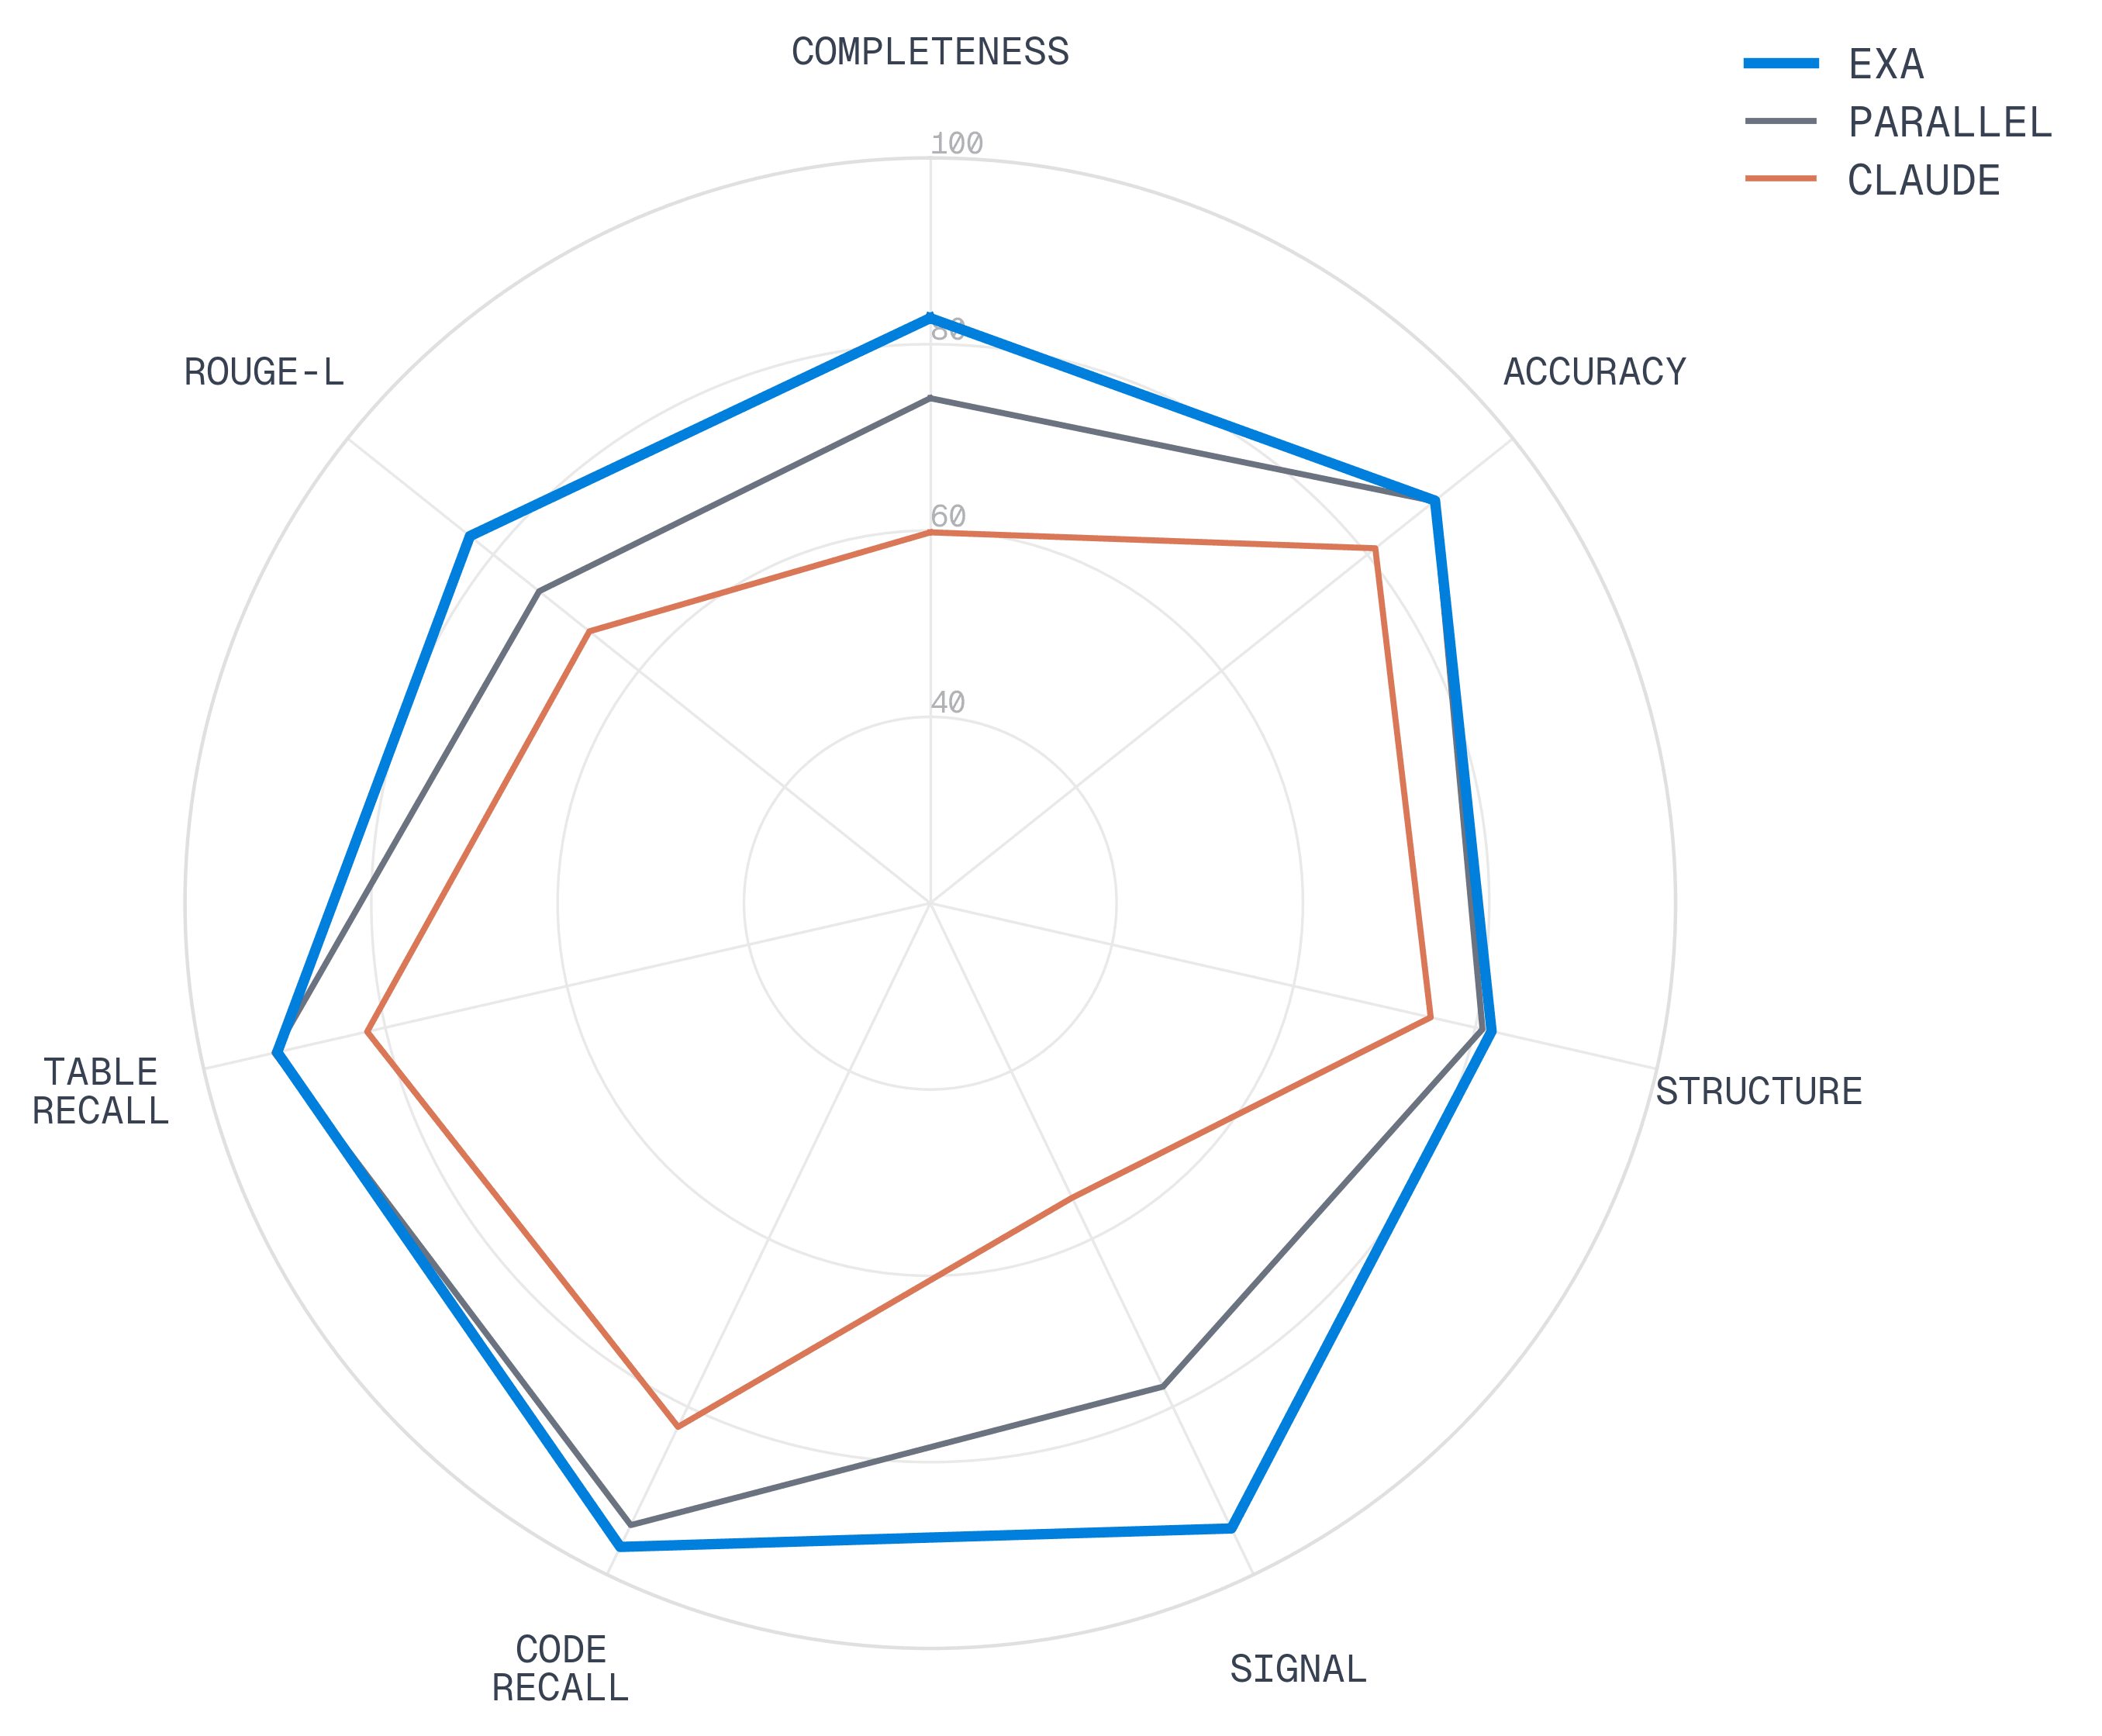
| 提供方 | 完整性 | Signal | 结构 | 准确性 | 代码回忆 | 表格召回率 | ROUGE-L |
|---|---|---|---|---|---|---|---|
| DataSEO | 82.8 | 94.5 | 81.8 | 89.3 | 96.7 | 91.9 | 83.2 |
| 示例数据集 | 74.2 | 77.6 | 80.8 | 89.2 | 94.1 | 92.2 | 73.7 |
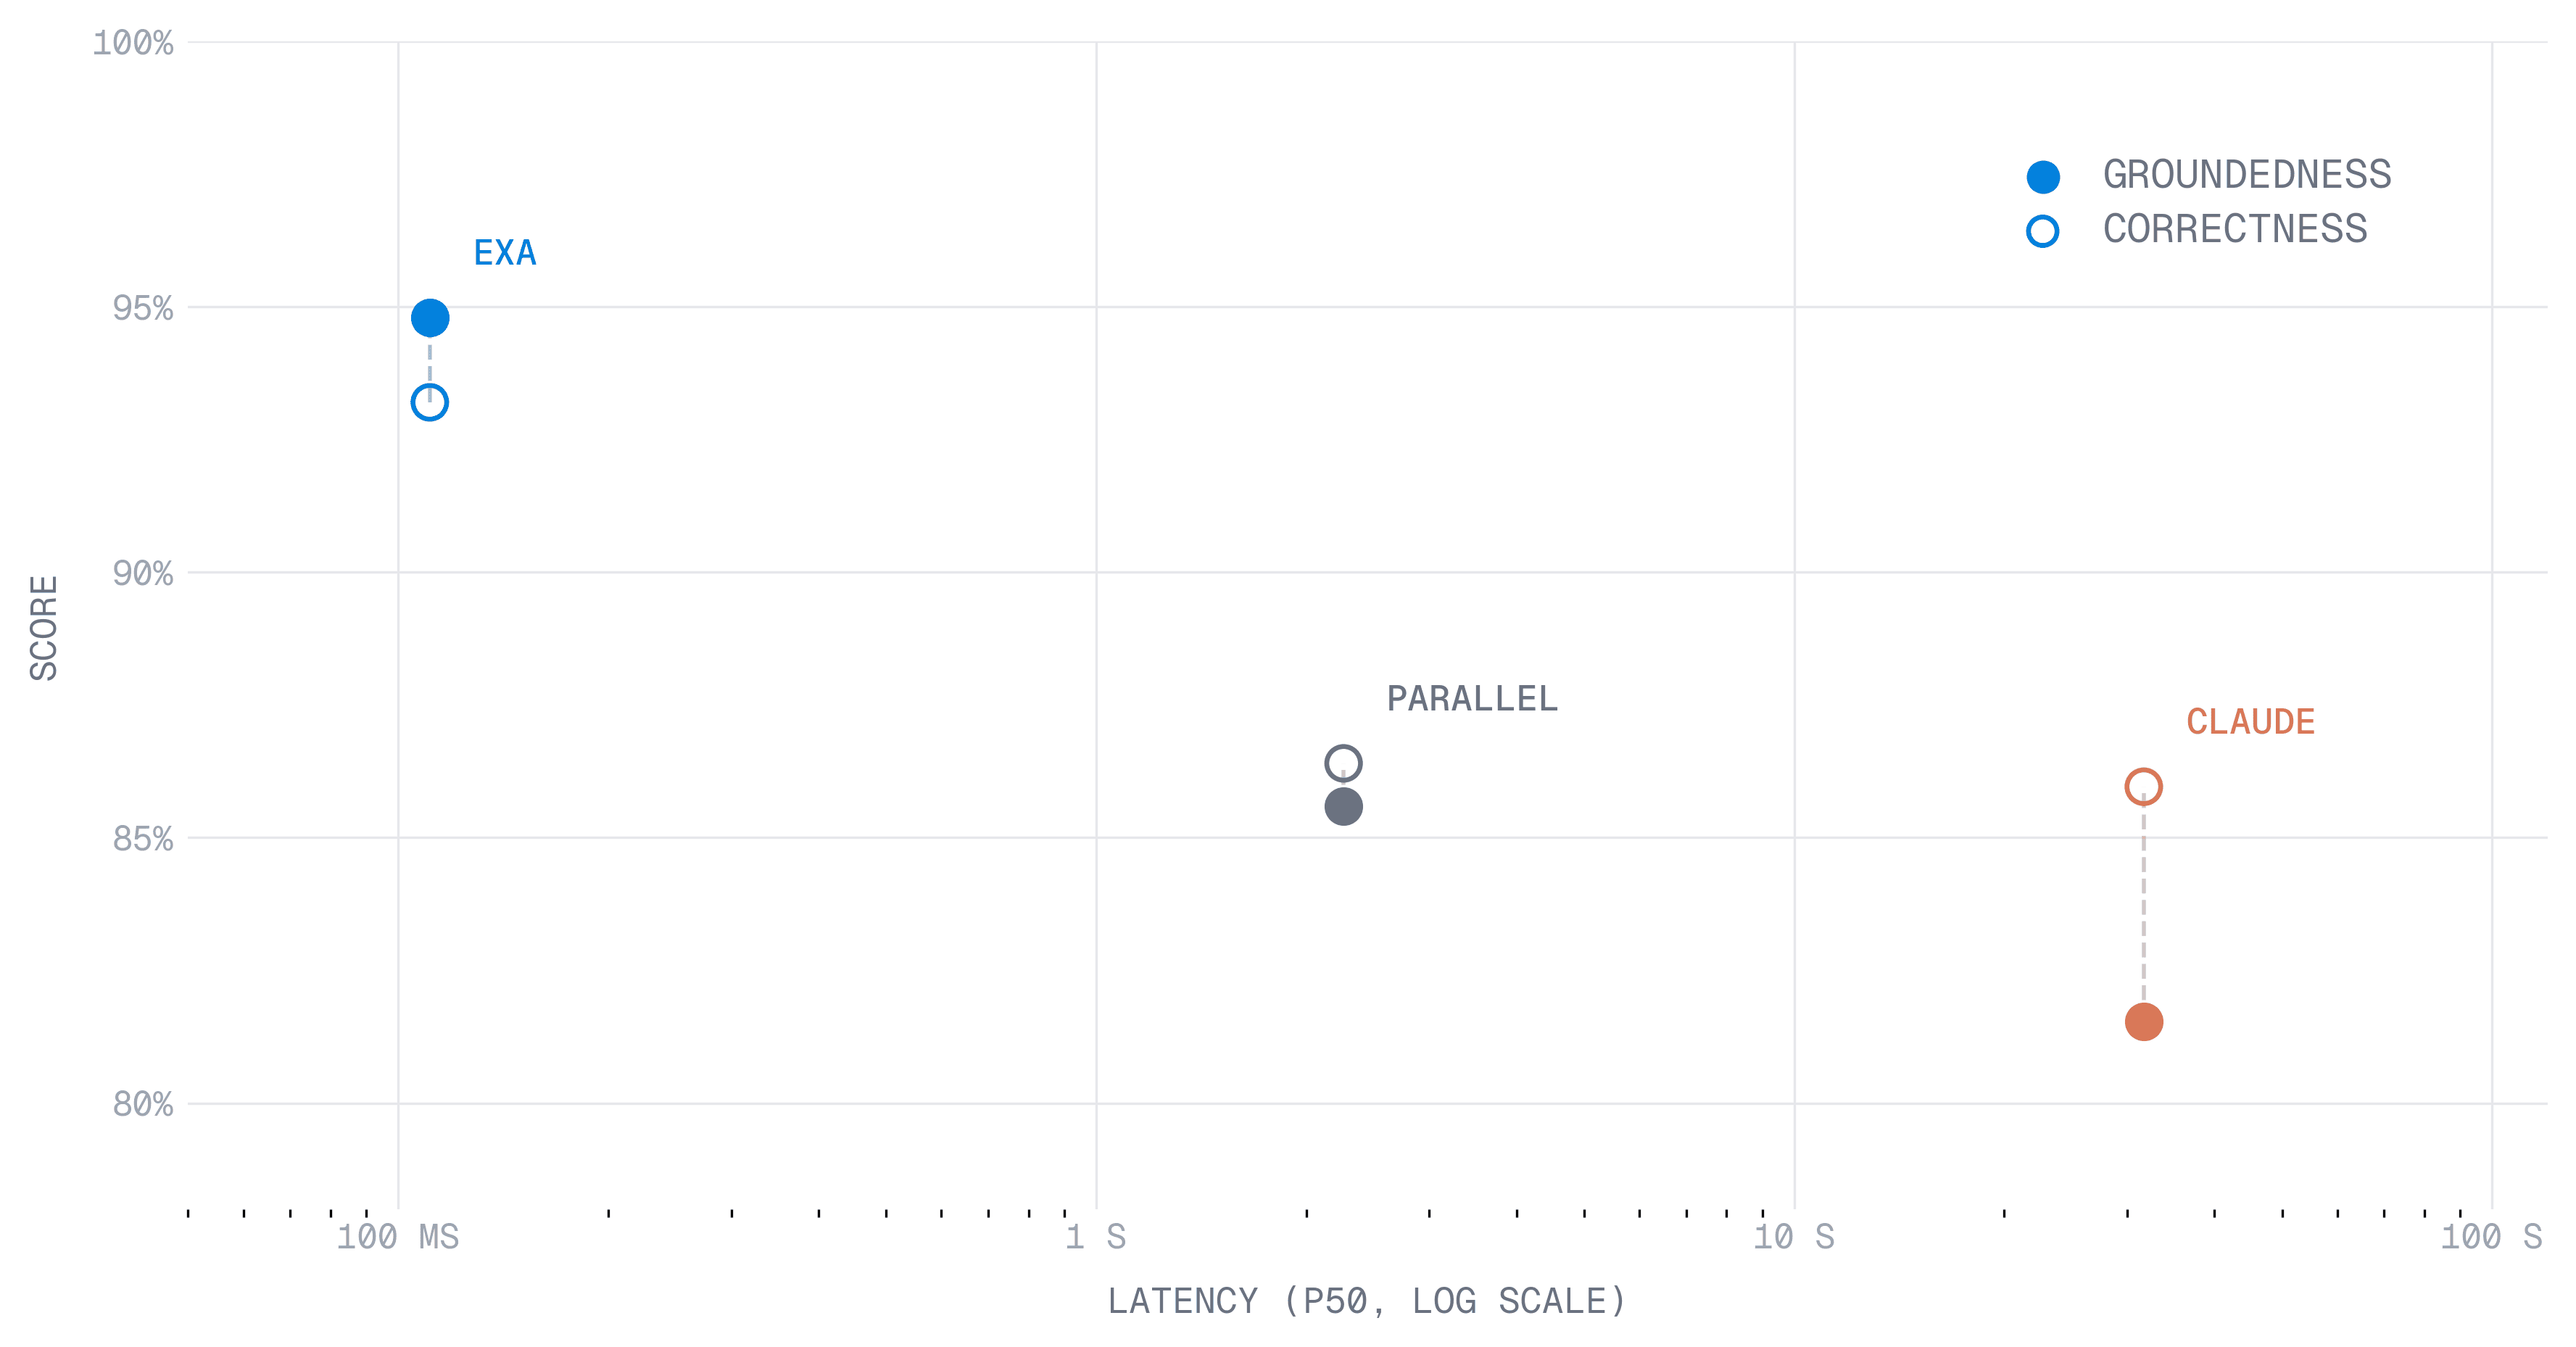
| Claude† | 59.8 | 55.1 | 75.1 | 81.1 | 82.4 | 82.0 | 66.8 |
对于每项发现,请保留受影响的 URL、证据、可能对用户造成的影响以及具体的修复方法。区分已确认的问题和需要进一步调查的疑问。
查看内部链接
在优化细节之前,先修复直接索引和导航故障 次要元数据。排序 根据业务重要性、影响和实施工作量安排剩余工作。
检查元数据和重复内容
修复后重复相关检查并比较证据。测试成功可证明所检查的行为,但不能保证未来的搜索排名。
清单:从对客户最重要的 URL 入手:关键落地页、产品页面和有代表性的模板。记录目标是提升可爬取性、索引、内容质量还是页面性能。
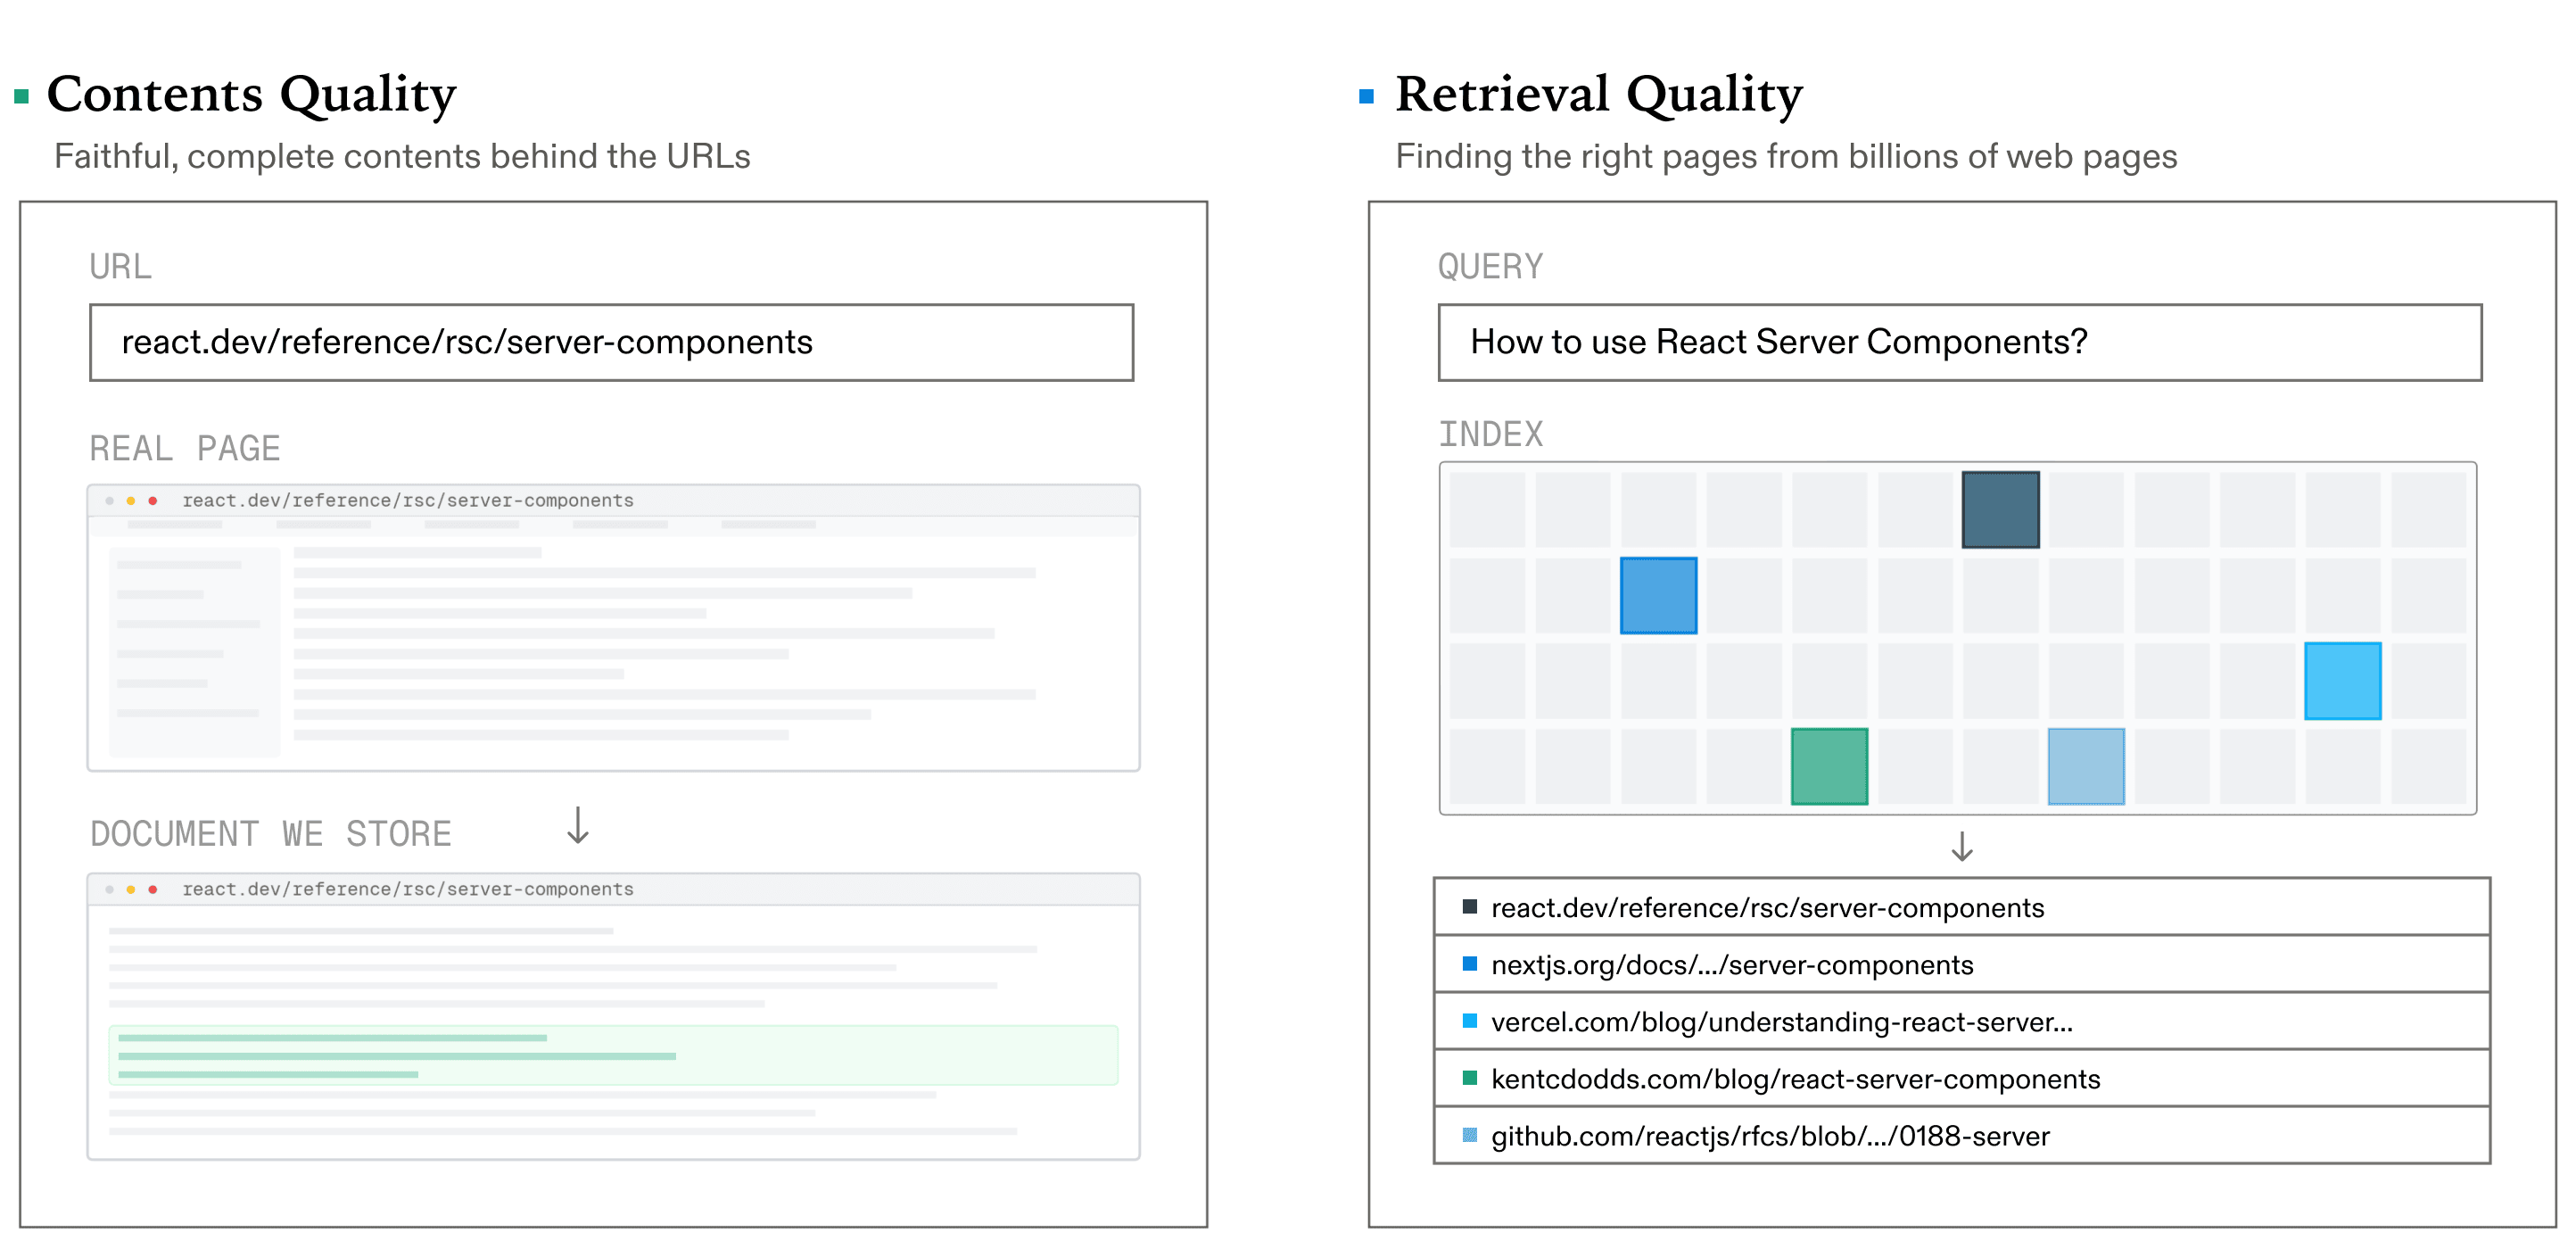
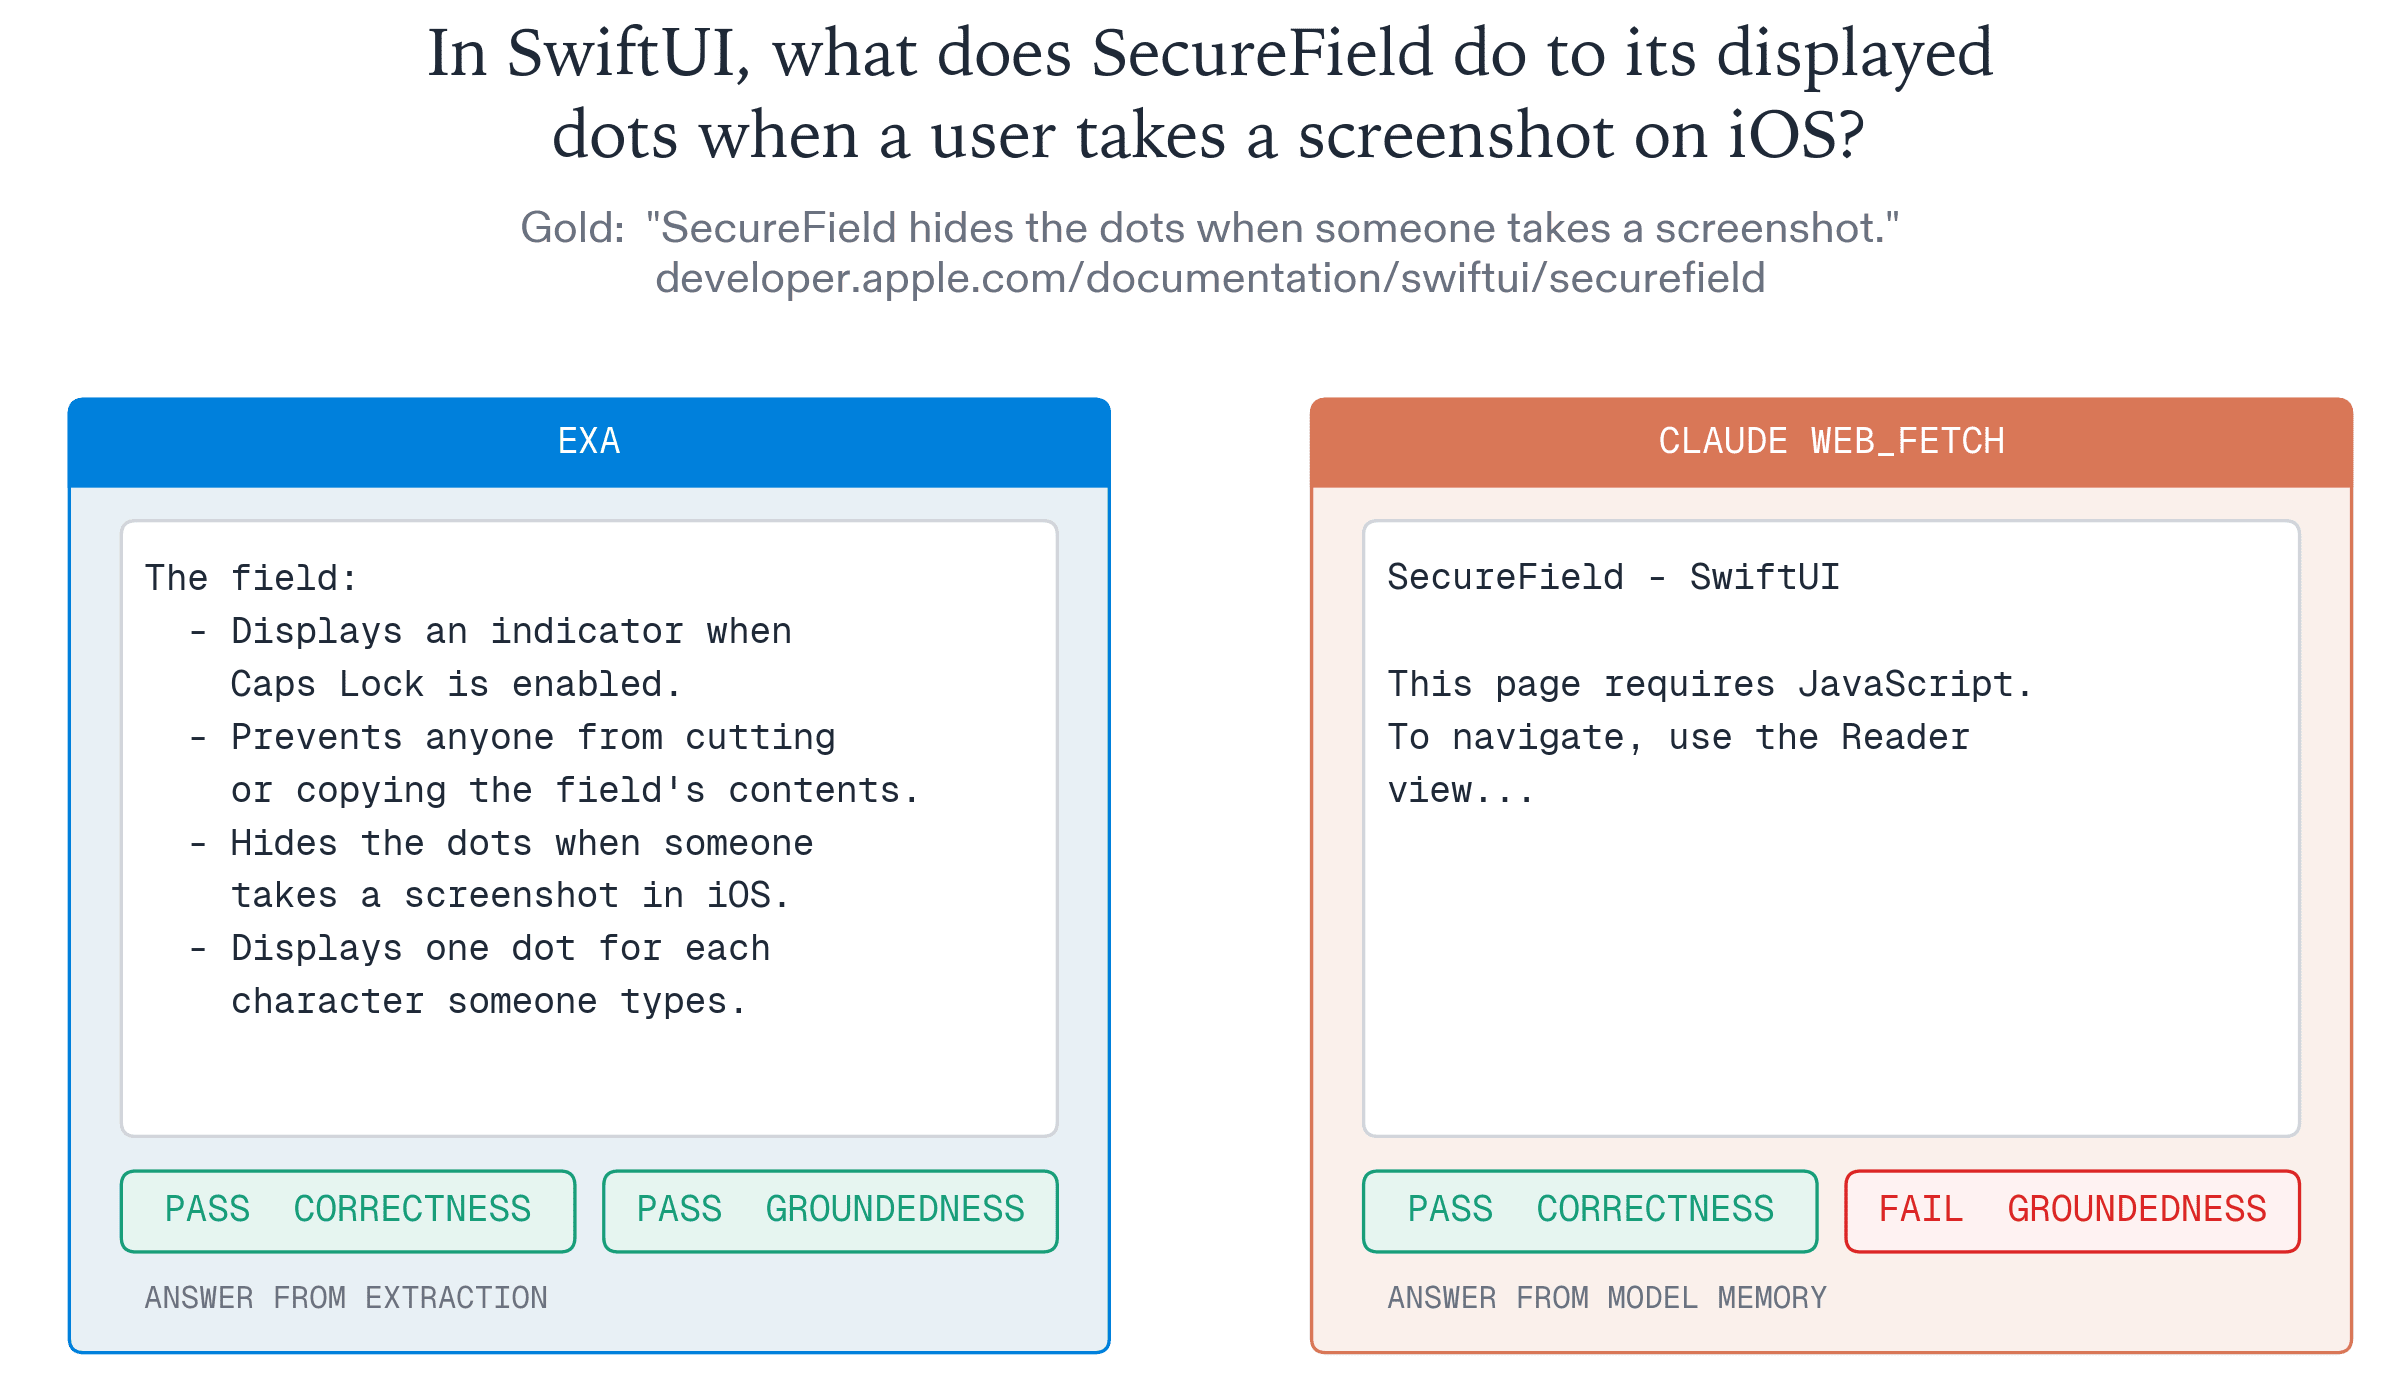
- 要点错误,但综合处理的 LLM 给出了正确答案
- 要点正确,但综合处理的 LLM 给出了错误答案
清单:使用固定的抓取设置并 明确的页面限制。 提前停止的抓取无法证明网站上的每个页面都运行正常。
清单:保留带日期的记录 目标对象、渲染 选择和采集路径。 这样可以让之后的比较有据可循,避免混合在不同条件下采集的结果。
- 从您需要调查的目标和市场开始。将来源和采集时间与每个 On-Page API 响应一并保留。
- 如果您的问题涉及搜索可见度、需求、链接、页面健康度或 AI 引用,可将 On-Page API 与互补数据集结合使用。
选择渲染方式和性能测试
清单:检查 HTTP 响应 读取页面内容之前。重定向、错误响应或被拦截的请求,需要采用不同于成功返回 HTML 页面的调查方式。
清单:检查 robots meta 标签和规范链接 URLs in the returned 文档。noindex 指令表示有意排除在搜索之外,而 canonical 表示首选 URL;它们 解决不同的问题。
确定修复优先级并进行验证
清单:当模板在许多 URL 上生成相同问题时,手动检查有代表性的页面。修复模板可能比逐个编辑渲染后的页面更有效。
清单:按引荐页面和目标对失效链接分组。优先处理会阻止用户或爬虫访问重要内容的链接。
定义审计范围
检查状态和可编入索引性
清单:将内部链接目标与首选 URL 集合进行比较。直接链接到规范页面,而不要依赖一连串重定向。
检查清单:在限定范围内抓取时,未找到的页面可能位于抓取范围之外。请验证 独立验证 URL 后 将其标记为孤立页面或已删除页面。
清单:查找标题 以及能够准确标识的描述 每个页面的用途。在每个产品页面中重复相同的通用表述 对用户没有帮助 区分它们。
查看内部链接
清单:根据主要内容和意图比较重复页面候选项。决定是将其合并、为已停用的路由设置重定向,还是创建真正不同的信息。
清单:在内部链接、规范标签和站点地图中使用相同的首选 URL。信号不一致会增加识别目标 URL 的难度。
清单:从能够提供所需内容的最简单采集方式入手。依赖 JavaScript 的模板可能需要浏览器,但使用浏览器采集需要不同的资源。
- 按类型和优先级对抓取问题分组,然后在修复后检查受影响的网址。
-
设置关键词、搜索引擎、位置、语言和设备。保留这些设置,并用于每次观测,以便排名比较反映相同的受众和市场。
- 研究自然搜索、地图、新闻、图片、购物及其他受支持的结果类型。使用项目类型解读各端点返回的字段。
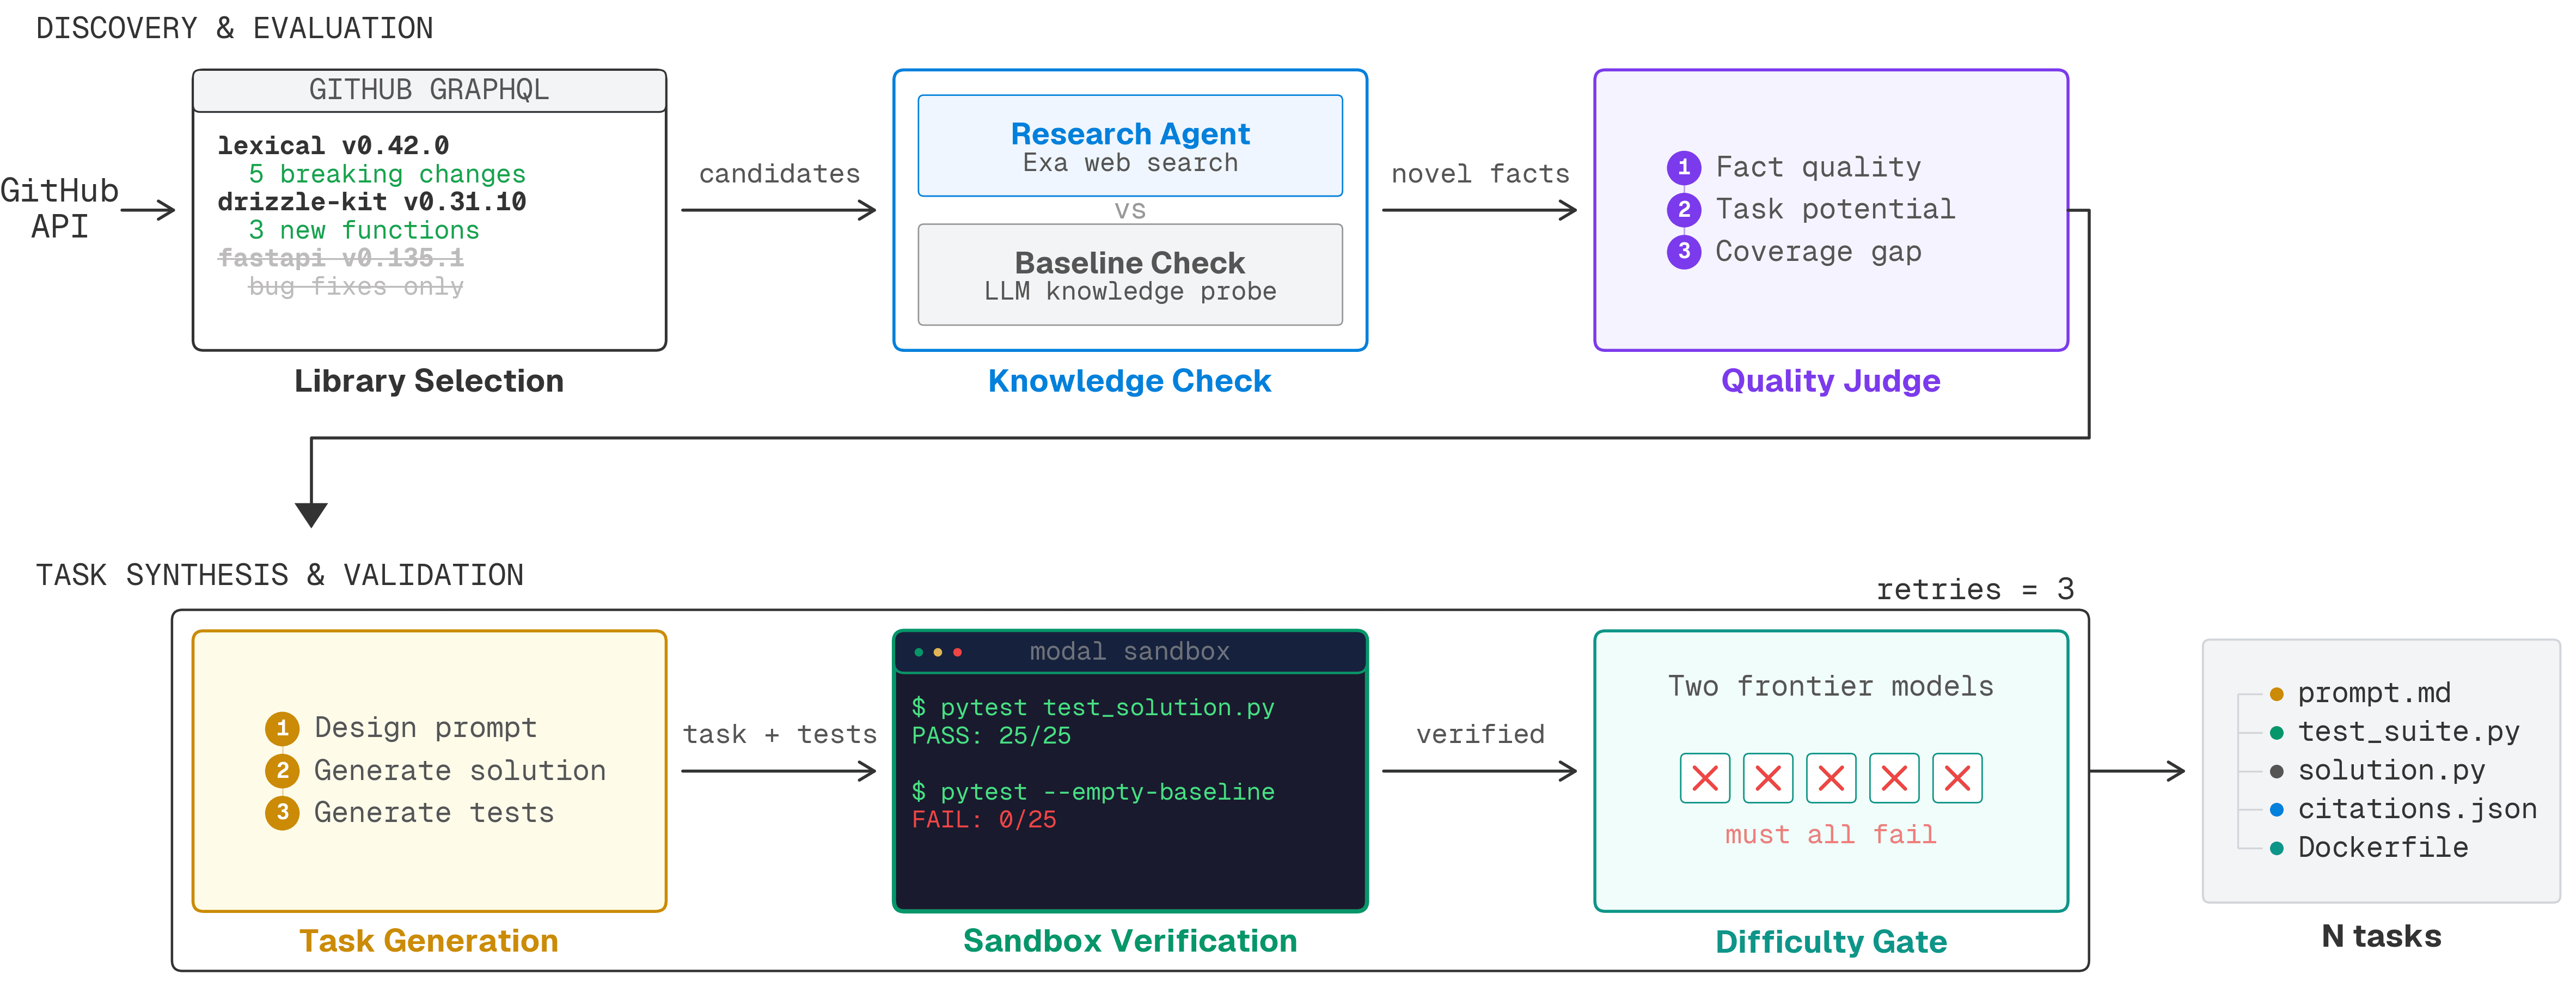
- 任务生成: 使用新颖事实生成了任务提示、解决方案和测试套件
- 无需。请为要检查的网站选择渲染和审计选项。额外处理可能影响采集成本和速度。
- 从您需要调查的目标和市场开始。将来源和采集时间与每个 On-Page API 响应一并保留。
清单:将 Lighthouse 结果视为特定条件下的一次实验室测试。没有现场测量数据时,不要将其结果报告为真实用户的 Core Web Vitals。
清单:排查加载问题时,检查图片、字体和第三方资源。更改资源后,在可比条件下重新测试同一页面。
检查元数据和重复内容
清单:针对每项发现,保留受影响的 URL、证据、可能对用户造成的影响以及具体的修复方法。区分已确认的问题与仍需进一步调查的问题。
清单:在优化细节之前,先修复直接索引和导航故障 探索 On-Page API → 根据业务重要性、影响和实施工作量进行排序。
清单:修复后重新进行相关检查并比较证据。测试成功只能证明已检查的行为符合预期,并不能保证未来的搜索排名。
查看开放职位-
1
.
实践建议:从对客户最重要的 URL 入手:关键落地页、产品页和有代表性的模板。记录目标是可抓取性、 索引编制、内容质量或页面表现。