तकनीकी SEO समस्याओं की जाँच कैसे करें
स्थिति और इंडेक्स होने की पात्रता की जांच करें
उन URL से शुरू करें जो ग्राहकों के लिए मायने रखते हैं: मुख्य लैंडिंग पेज, उत्पाद पेज और प्रतिनिधि टेम्पलेट। दर्ज करें कि लक्ष्य क्रॉलेबिलिटी, इंडेक्सिंग, सामग्री की गुणवत्ता या पेज का प्रदर्शन है।
क्रॉल सेटिंग का एक निश्चित सेट और पेजों की स्पष्ट सीमा तय करें। बीच में रुक जाने वाला क्रॉल यह साबित नहीं कर सकता कि साइट का हर पेज ठीक है।
लक्ष्य, रेंडरिंग विकल्प और डेटा संग्रह रूट का दिनांकित रिकॉर्ड रखें। इससे अलग-अलग परिस्थितियों में एकत्र किए गए नतीजों को मिलाने के बजाय बाद की तुलना को समझाना संभव होता है।
पेज की सामग्री पढ़ने से पहले HTTP प्रतिक्रिया की समीक्षा करें। रीडायरेक्ट, त्रुटि प्रतिक्रिया या अवरुद्ध अनुरोध की जाँच, सफल HTML पेज से अलग तरीके से करनी होगी।
आंतरिक लिंक की समीक्षा करें
लौटाए गए दस्तावेज़ में robots meta टैग और canonical URL जाँचें। noindex निर्देश खोज से जानबूझकर बाहर रखता है, जबकि canonical पसंदीदा URL बताता है; दोनों अलग-अलग समस्याओं का समाधान करते हैं।
जब कोई टेम्पलेट कई URL पर एक ही समस्या पैदा करता है, तो प्रतिनिधि पेजों की मैन्युअल रूप से जांच करें। हर रेंडर किए गए पेज को संपादित करने की तुलना में टेम्पलेट को ठीक करना अधिक प्रभावी हो सकता है।
टूटे हुए लिंक को उनके रेफ़रिंग पेज और लक्ष्य के आधार पर समूहित करें। उन लिंक को प्राथमिकता दें जो उपयोगकर्ताओं या क्रॉलरों को अहम सामग्री तक पहुँचने से रोकते हैं।
आंतरिक गंतव्यों की पसंदीदा URL सूची से तुलना करें। रीडायरेक्ट की श्रृंखला पर निर्भर रहने के बजाय सीधे कैनॉनिकल पेजों से लिंक करें।
मेटाडेटा और डुप्लिकेशन जाँचें
सीमित दायरे वाले क्रॉल में कोई पेज छूट सकता है क्योंकि वह क्रॉल के दायरे से बाहर हो। उसे अनाथ या हटाया गया पेज कहने से पहले URL की स्वतंत्र रूप से पुष्टि करें।
- ऑन-पेज गुणवत्ता - ऐसी सामग्री जो क्वेरी का सही उत्तर देती है
- जब आपके सवाल में सर्च दृश्यता, मांग, लिंक, पेज स्वास्थ्य या AI उद्धरण शामिल हों, तो On-Page API को पूरक डेटासेट के साथ मिलाएँ।
रेंडरिंग और प्रदर्शन परीक्षण चुनें
सुधारों को प्राथमिकता दें और सत्यापित करें
ऐसे शीर्षक और विवरण चुनें जो हर पेज के उद्देश्य की सटीक पहचान करें। हर उत्पाद पर एक ही सामान्य कथन दोहराने से उपयोगकर्ताओं को उनमें अंतर समझने में मदद नहीं मिलती।
डुप्लिकेट उम्मीदवारों की तुलना उनकी मुख्य सामग्री और इंटेंट के आधार पर करें। तय करें कि उन्हें एकीकृत करना है, बंद किए गए रूट पर रीडायरेक्ट करना है या वास्तव में अलग जानकारी बनानी है।
वही पसंदीदा URL उपयोग करें आंतरिक लिंक में, canonical टैग और साइटमैप। परस्पर विरोधी संकेतों से इच्छित URL की व्याख्या करना कठिन हो जाता है।
ऑडिट का दायरा तय करें
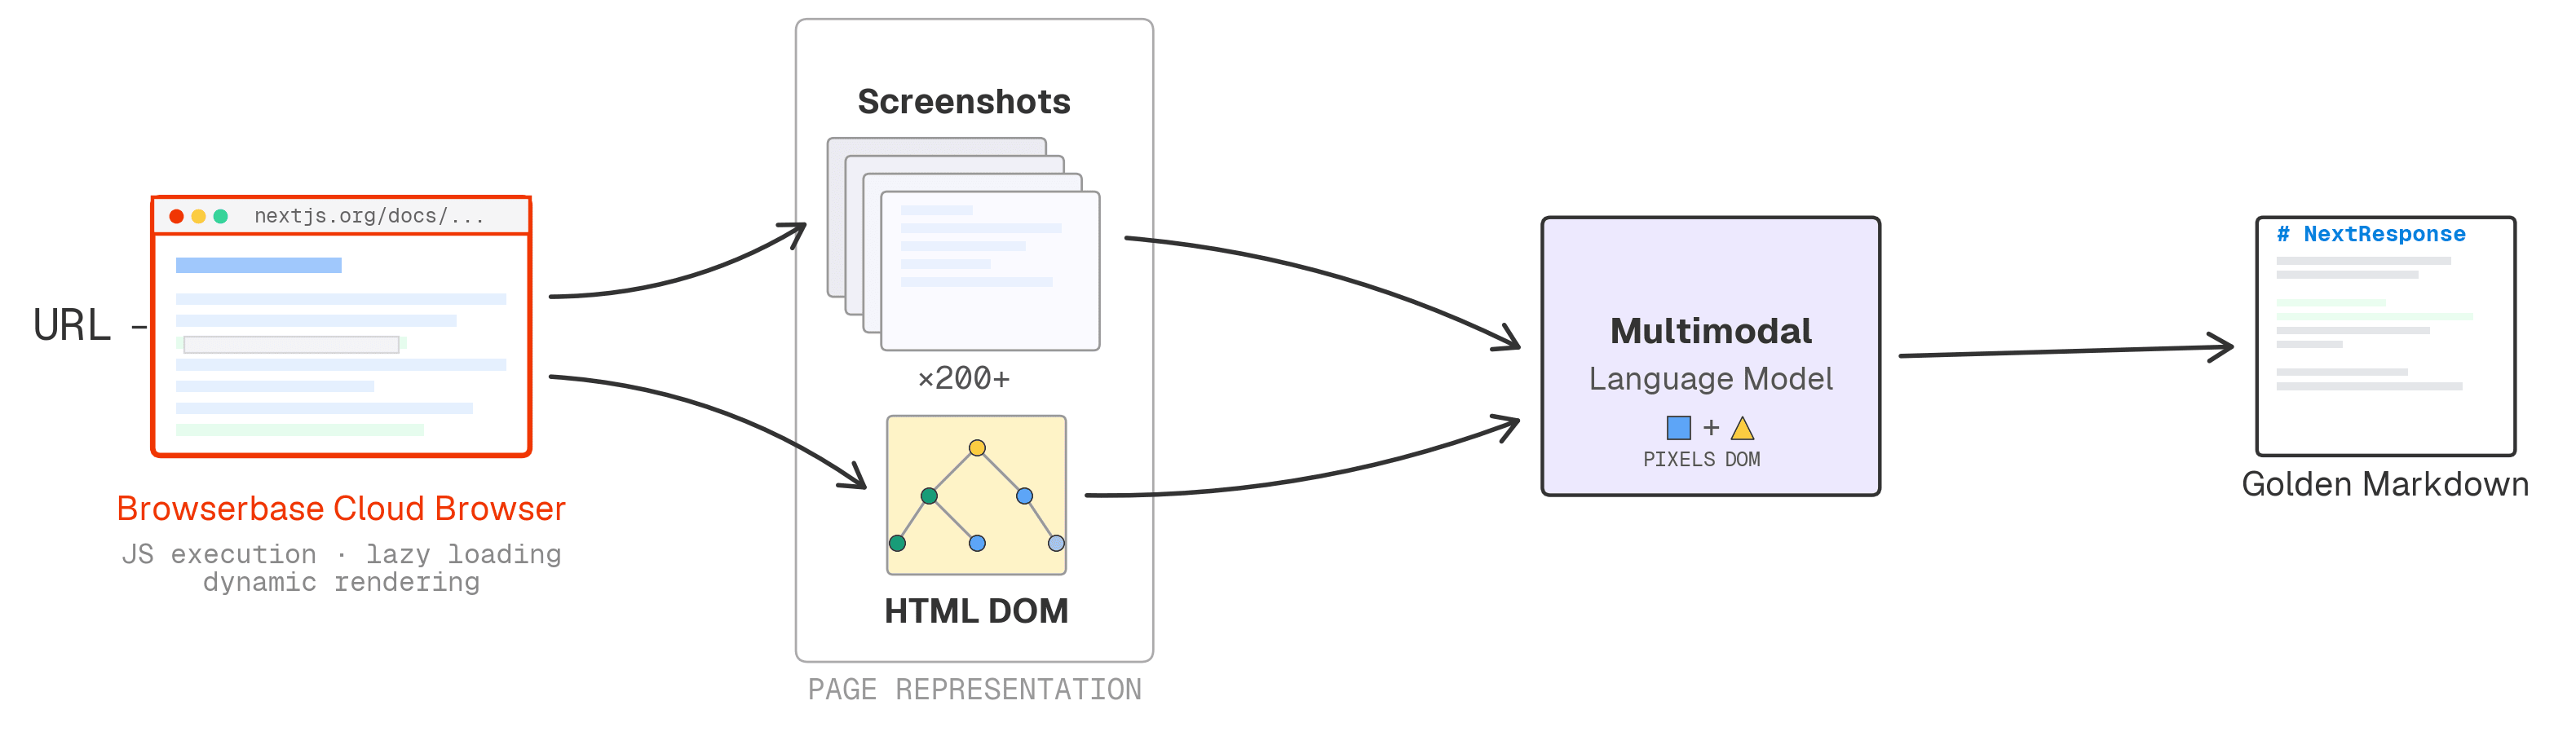
सबसे सरल डेटा संग्रह से शुरू करें जो आपको ज़रूरी सामग्री उपलब्ध कराता हो। JavaScript पर निर्भर टेम्प्लेट के लिए ब्राउज़र की आवश्यकता हो सकती है, लेकिन ब्राउज़र-आधारित संग्रह की संसाधन संबंधी ज़रूरतें अलग होती हैं।
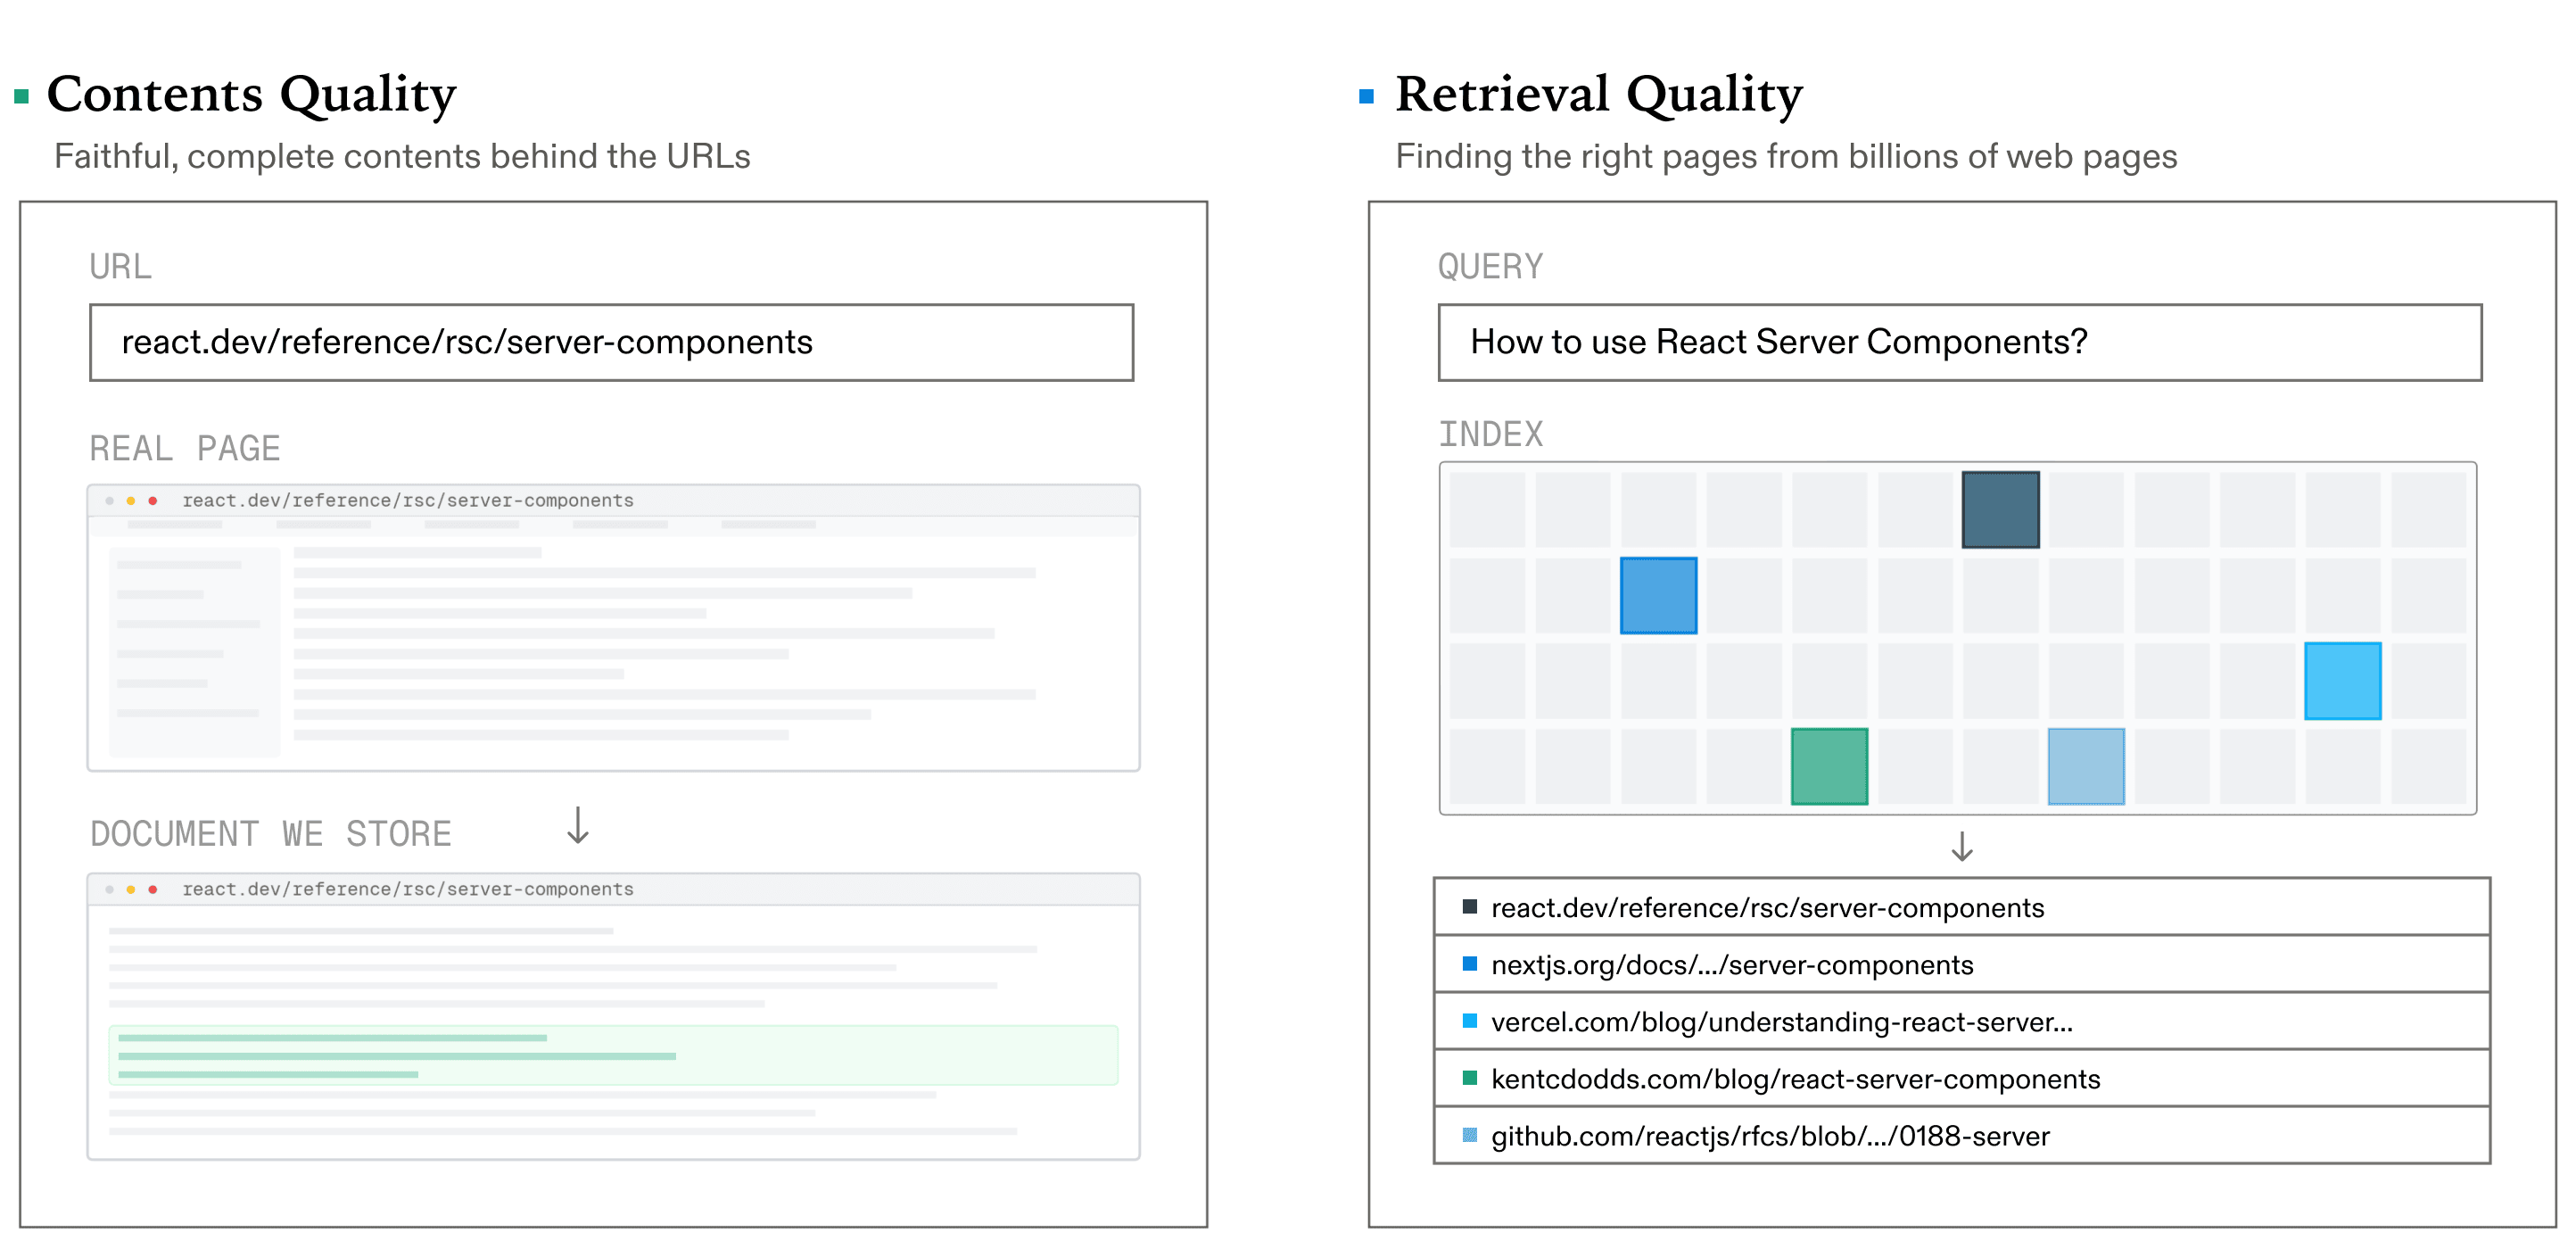
- सही ढंग से फ़ेच करें, लेकिन फ़ॉर्मैटिंग बिगाड़ दें
- आधी पेज सामग्री हटाते हुए संरचना को पूरी तरह सुरक्षित रखें
Lighthouse की व्याख्या विशेष परिस्थितियों में किए गए लैब परीक्षण के रूप में करें। फ़ील्ड माप के बिना इसके नतीजे को वास्तविक उपयोगकर्ताओं के Core Web Vitals नतीजे के रूप में रिपोर्ट न करें।
- कीवर्ड, सर्च इंजन, स्थान, भाषा और डिवाइस सेट करें। हर ऑब्ज़र्वेशन के साथ इन सेटिंग्स को सुरक्षित रखें, ताकि रैंकिंग की तुलनाएँ एक ही ऑडियंस और बाज़ार का वर्णन करें।
- ऑर्गेनिक सर्च, मैप्स, न्यूज़, इमेज, शॉपिंग और अन्य समर्थित परिणाम प्रकारों पर शोध करें। प्रत्येक endpoint से लौटाए गए फ़ील्ड को समझने के लिए आइटम प्रकारों का उपयोग करें।
स्थिति और इंडेक्स होने की पात्रता की जांच करें
लोड संबंधी समस्याओं की जाँच करते समय इमेज, फ़ॉन्ट और तृतीय-पक्ष संसाधन जाँचें। समान परिस्थितियों में उसी पेज का फिर से परीक्षण करें, इसके बाद किसी संसाधन को बदलना।
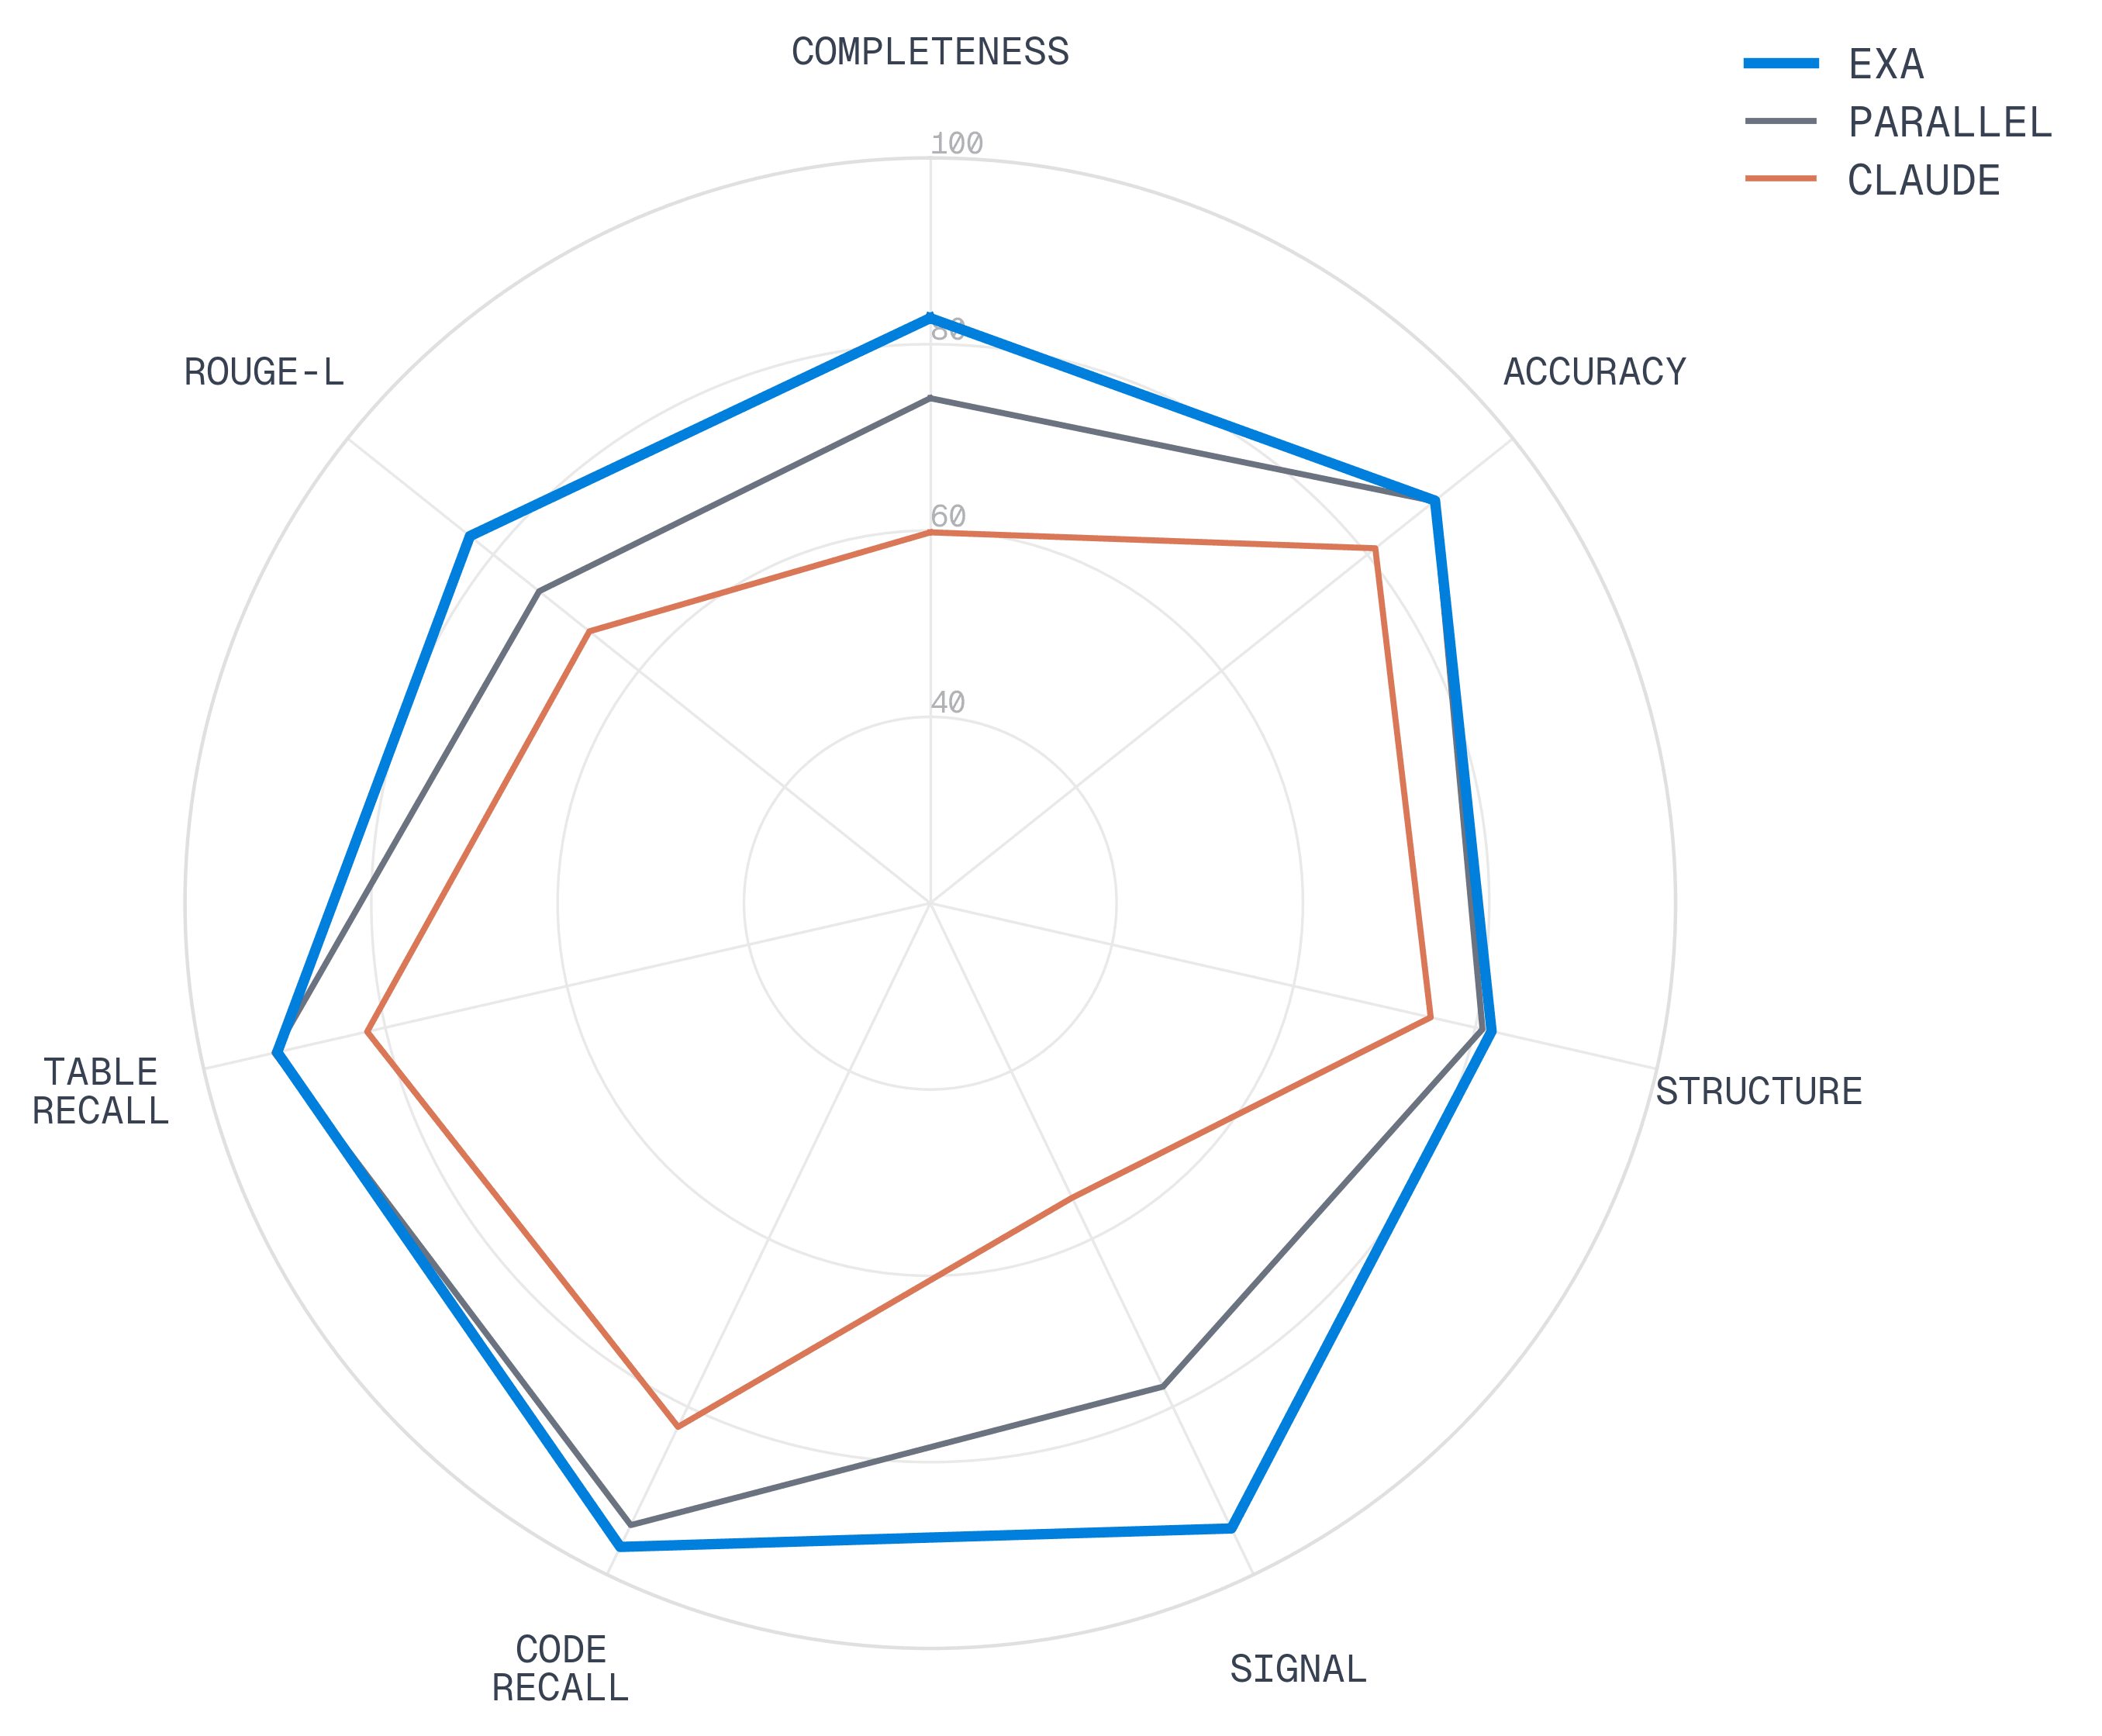
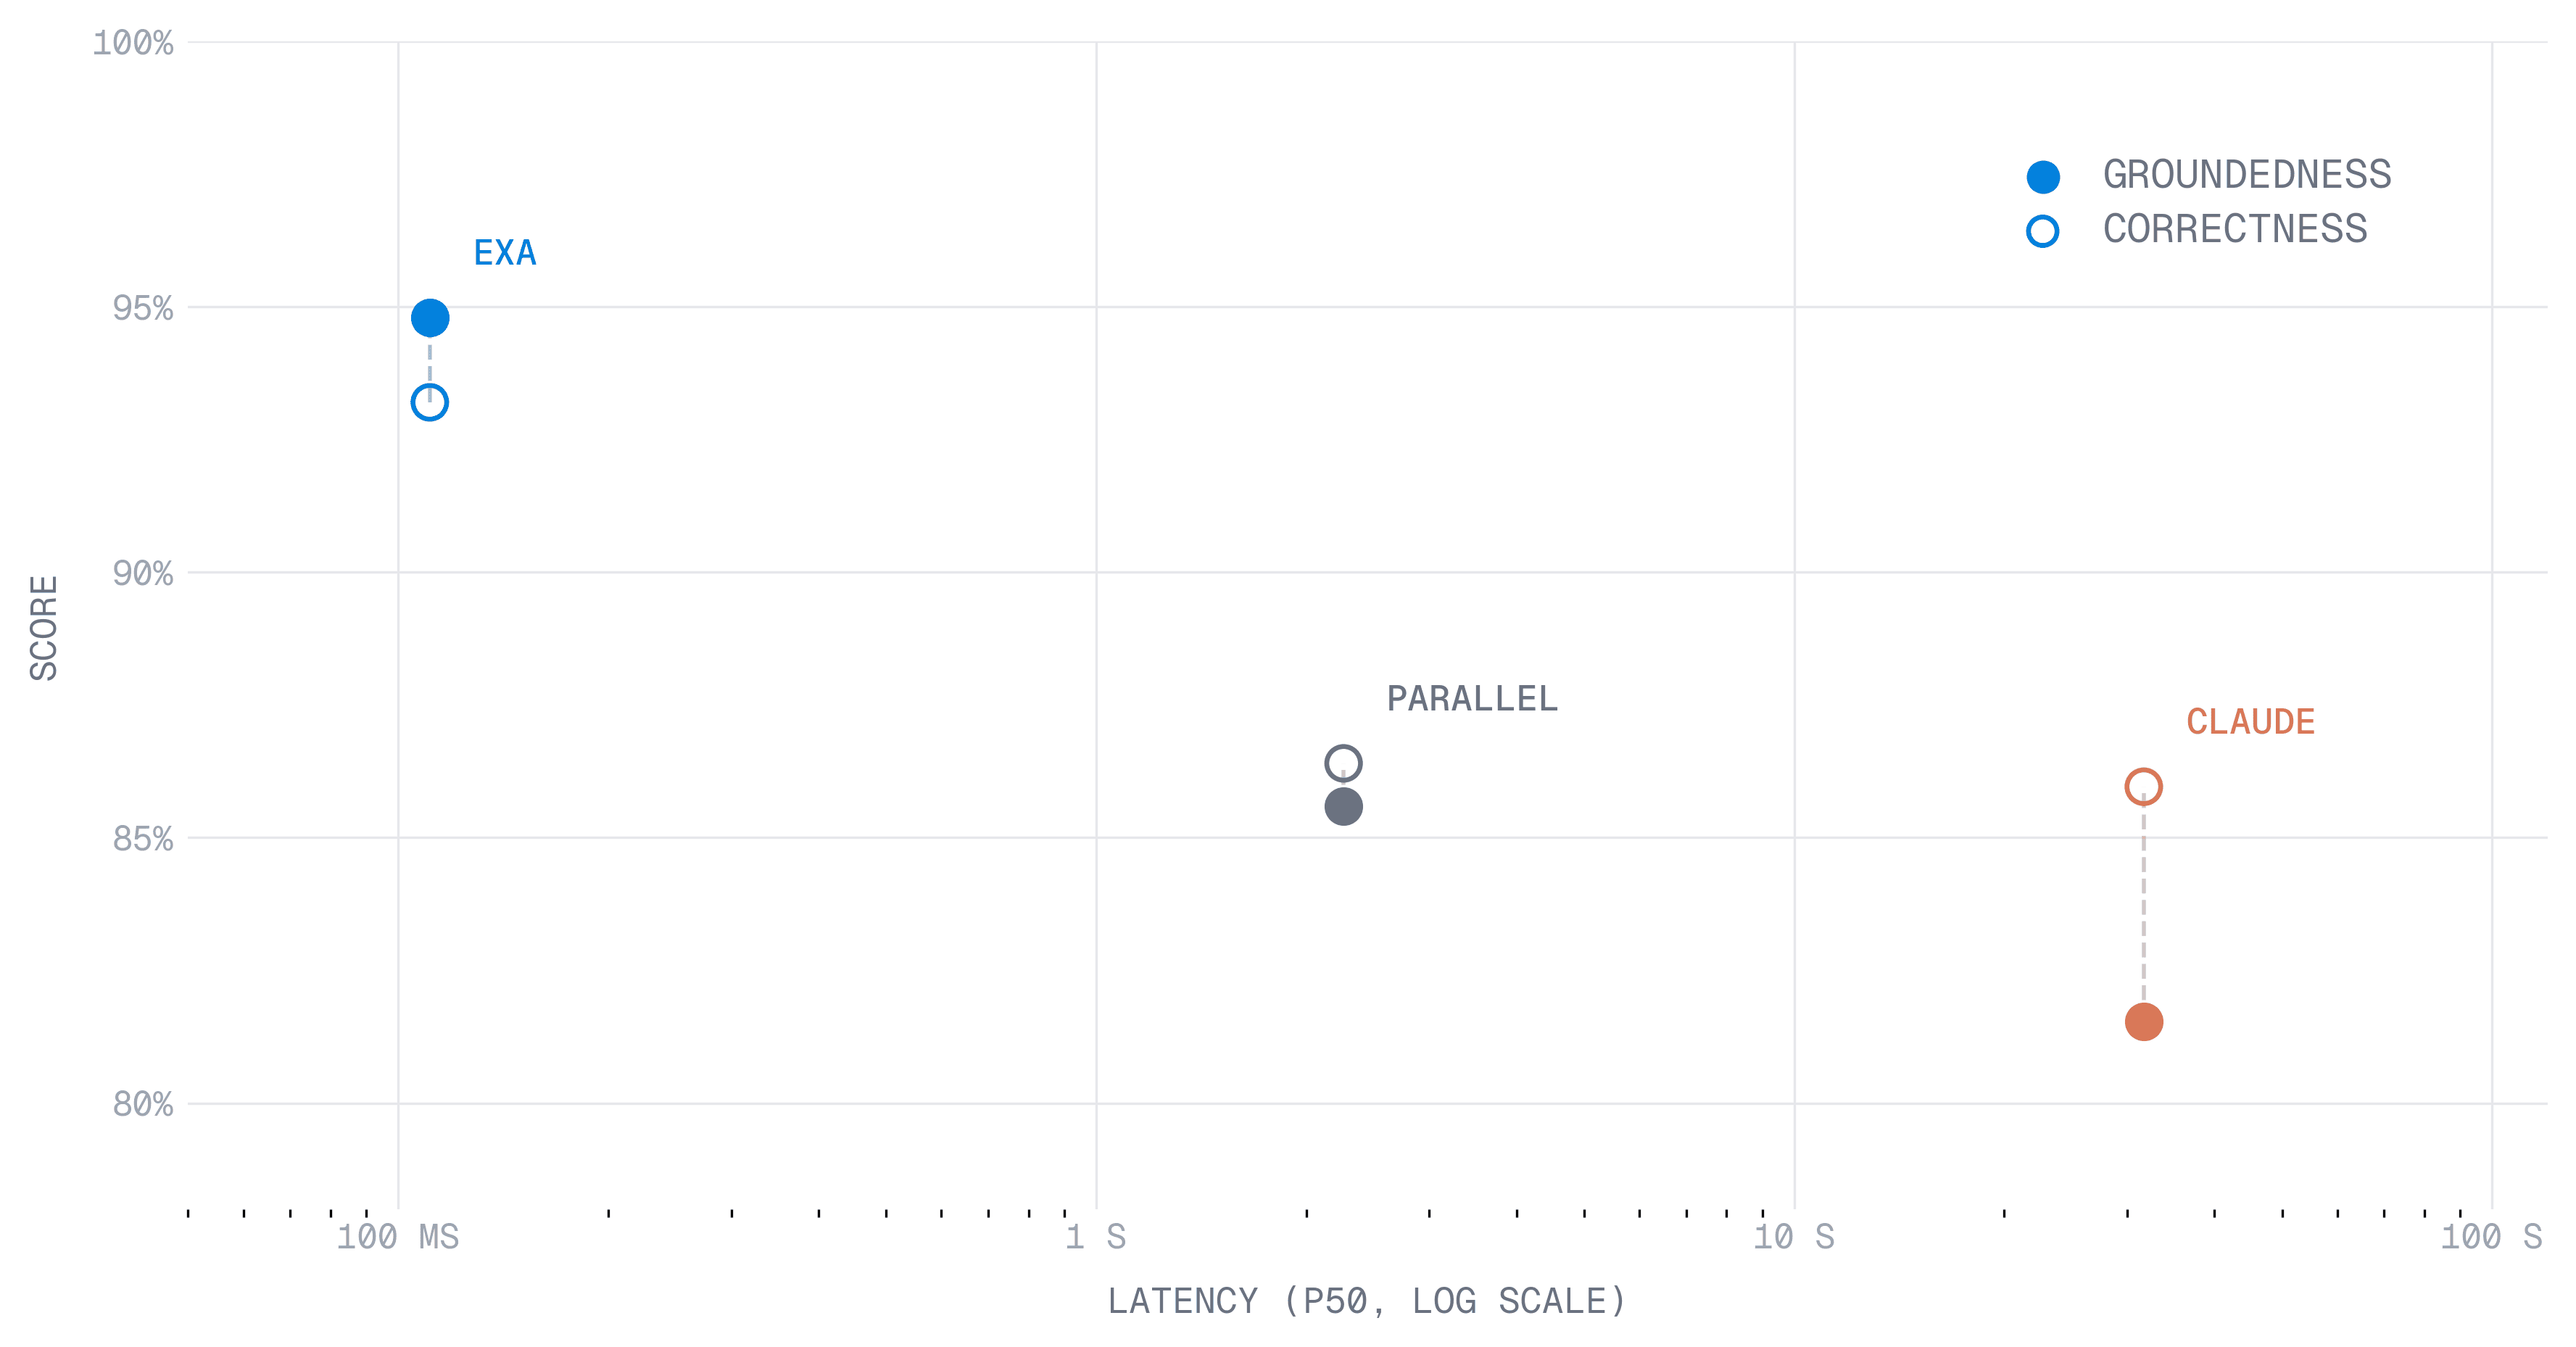
| प्रदाता | पूर्णता | Signal | संरचना | सटीकता | Code Recall | टेबल रिकॉल | ROUGE-L |
|---|---|---|---|---|---|---|---|
| DataSEO | 82.8 | 94.5 | 81.8 | 89.3 | 96.7 | 91.9 | 83.2 |
| उदाहरण कलेक्शन | 74.2 | 77.6 | 80.8 | 89.2 | 94.1 | 92.2 | 73.7 |
| Claude† | 59.8 | 55.1 | 75.1 | 81.1 | 82.4 | 82.0 | 66.8 |
हर निष्कर्ष के लिए प्रभावित URL, साक्ष्य, उपयोगकर्ता पर संभावित प्रभाव और ठोस समाधान दर्ज करें। पुष्ट समस्याओं और आगे जाँच की ज़रूरत वाले सवालों में अंतर रखें।
आंतरिक लिंक की समीक्षा करें
सुधार करने से पहले डायरेक्ट इंडेक्सिंग और नेविगेशन की विफलताओं को ठीक करें मामूली मेटाडेटा। क्रम व्यावसायिक महत्त्व, प्रभाव और कार्यान्वयन प्रयास के आधार पर शेष काम तय करें।
मेटाडेटा और डुप्लिकेशन जाँचें
सुधार के बाद संबंधित जाँचें दोहराएँ और साक्ष्यों की तुलना करें। सफल टेस्ट जाँचे गए व्यवहार को प्रमाणित करता है; यह भविष्य की सर्च रैंकिंग की गारंटी नहीं देता।
चेकलिस्ट: उन URL से शुरुआत करें जो ग्राहकों के लिए मायने रखते हैं: प्रमुख लैंडिंग पेज, उत्पाद पेज और प्रतिनिधि टेम्पलेट। दर्ज करें कि लक्ष्य क्रॉलेबिलिटी, इंडेक्सिंग, सामग्री की गुणवत्ता या पेज का प्रदर्शन है।
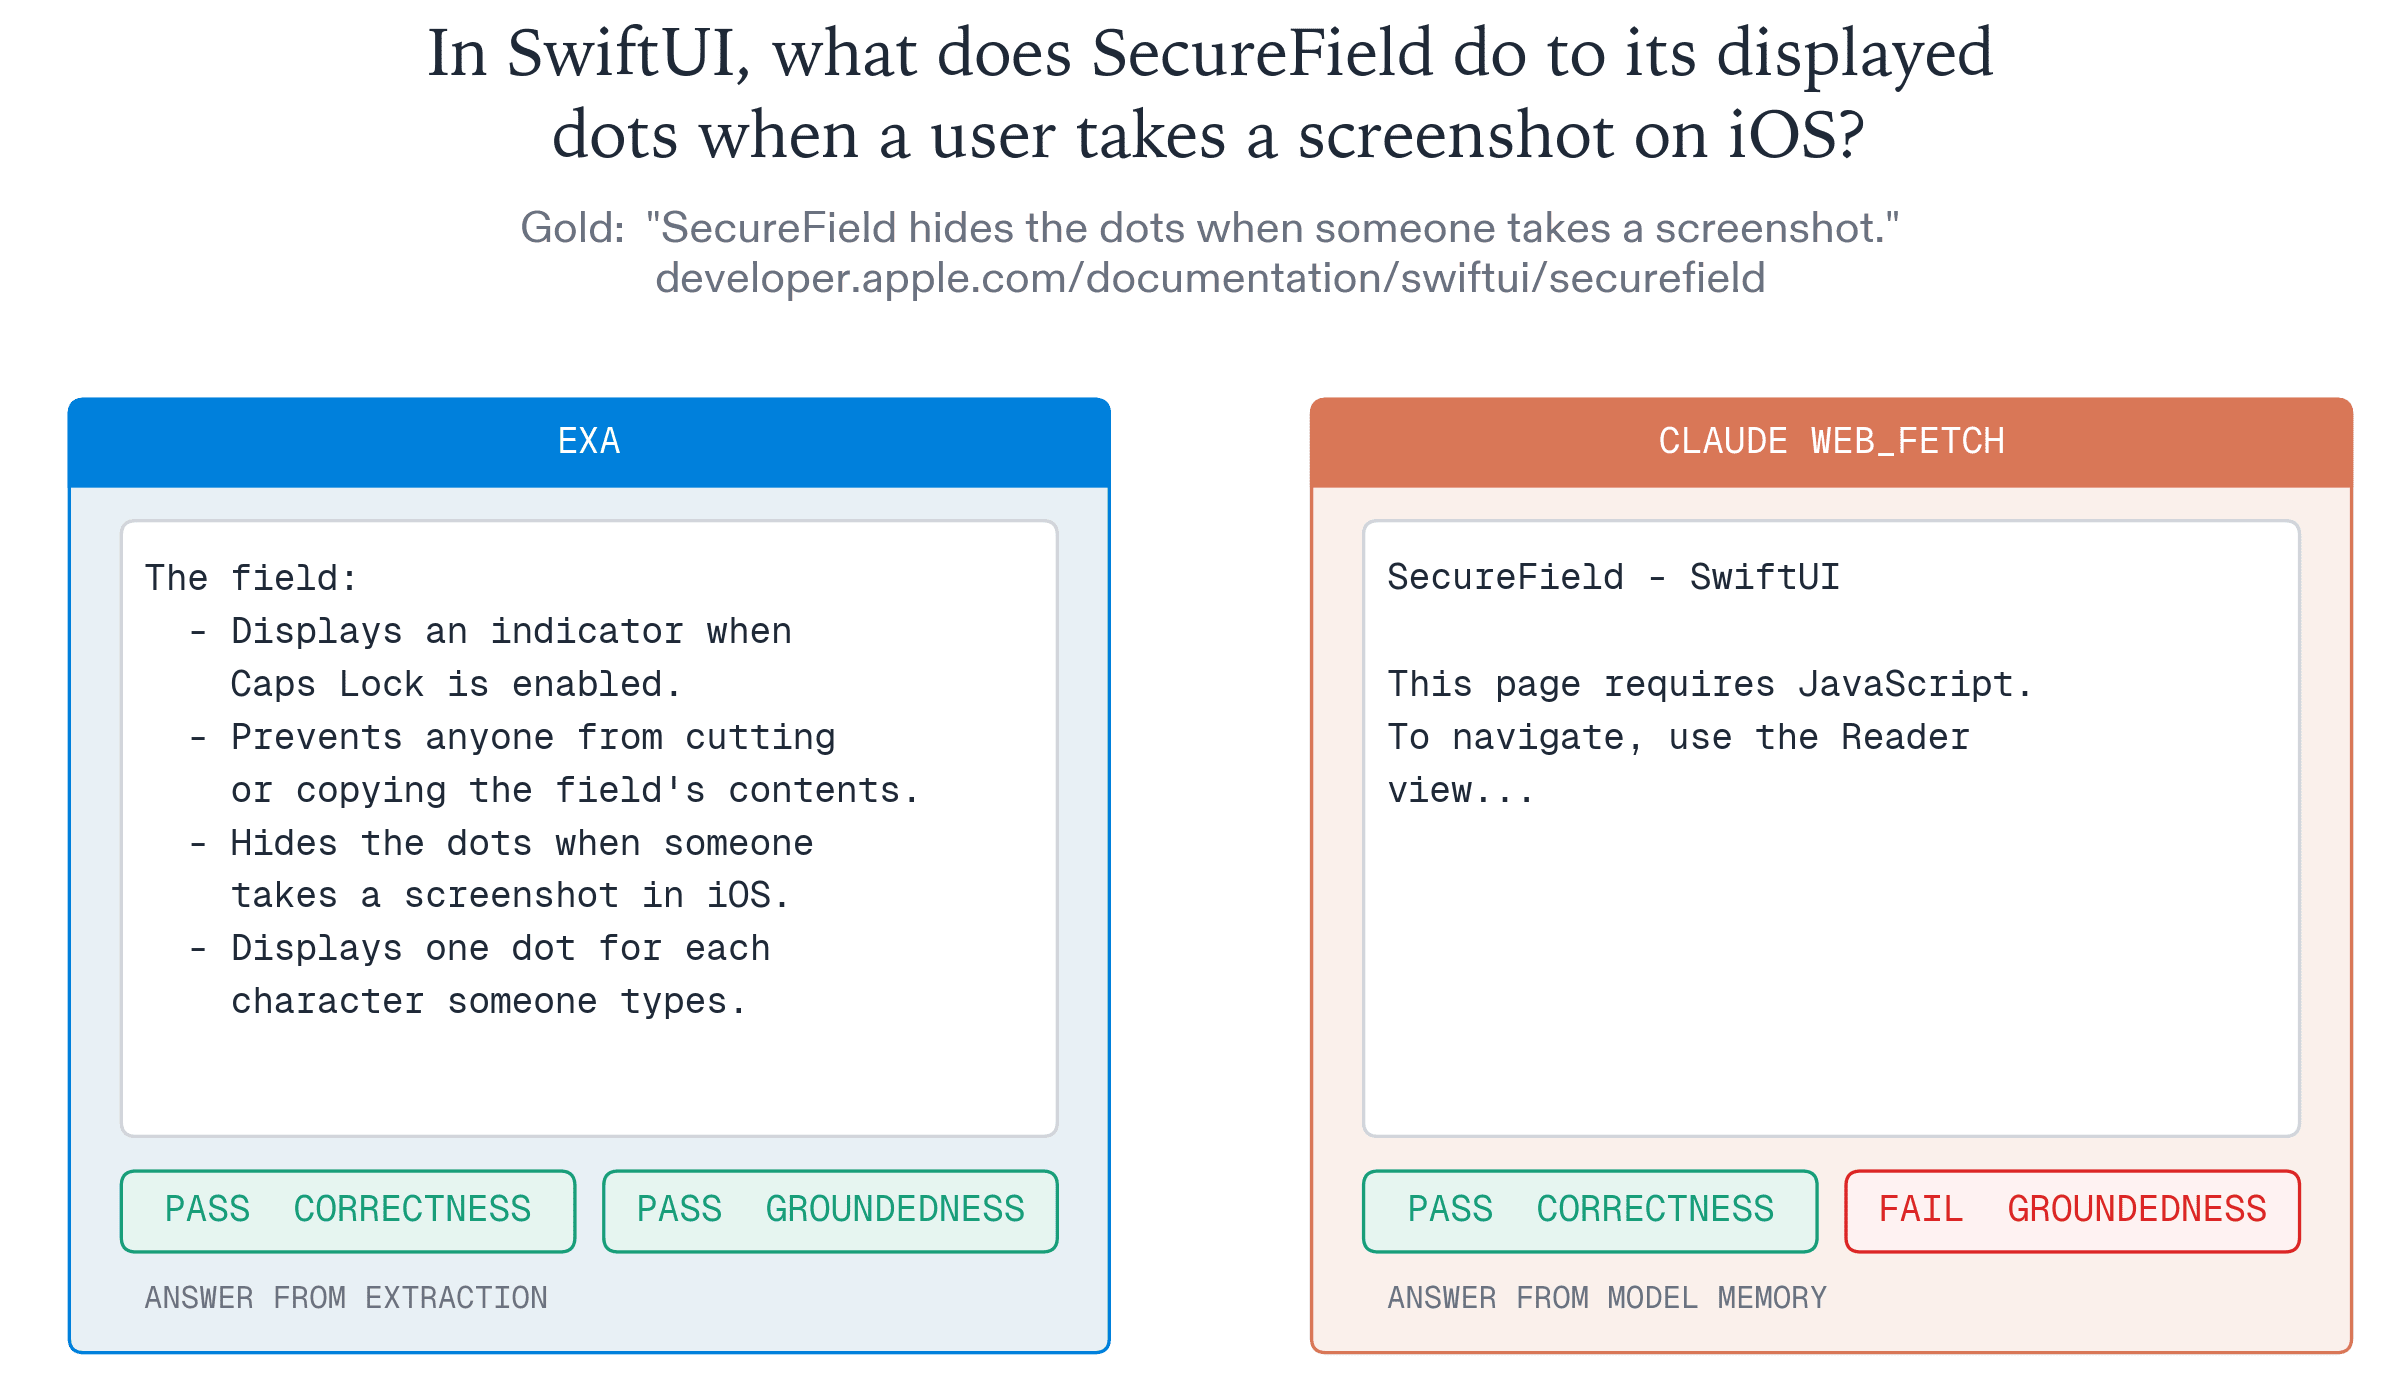
- मुख्य बिंदु गलत थे, लेकिन संश्लेषण LLM ने सही उत्तर दिया
- मुख्य बिंदु सही थे, लेकिन संश्लेषण LLM ने गलत उत्तर दिया
चेकलिस्ट: क्रॉल सेटिंग का एक निश्चित सेट और उपयोग करें एक स्पष्ट पेज सीमा। जो क्रॉल जल्दी रुक जाता है, वह यह सुनिश्चित नहीं कर सकता कि साइट का हर पेज सही स्थिति में है।
चेकलिस्ट: तारीख़ सहित रिकॉर्ड रखें लक्ष्य का, रेंडरिंग विकल्प और संग्रह मार्ग। इससे बाद में तुलना को समझाना आसान होता है और अलग-अलग परिस्थितियों में एकत्र किए गए नतीजे आपस में नहीं मिलते।
- जिन लक्ष्यों और बाज़ारों की जाँच करनी है, उनसे शुरू करें। हर On-Page API रिस्पॉन्स के साथ स्रोत और डेटा संग्रह का समय रखें।
- जब आपके सवाल में सर्च दृश्यता, मांग, लिंक, पेज स्वास्थ्य या AI उद्धरण शामिल हों, तो On-Page API को पूरक डेटासेट के साथ मिलाएँ।
रेंडरिंग और प्रदर्शन परीक्षण चुनें
चेकलिस्ट: HTTP रिस्पॉन्स की समीक्षा करें पेज की सामग्री पढ़ने से पहले। रीडायरेक्ट, त्रुटि प्रतिक्रिया या अवरुद्ध अनुरोध की जाँच, सफल HTML पेज की जाँच से अलग तरीके से करनी होगी।
चेकलिस्ट: robots की जाँच करें मेटा टैग और कैनॉनिकल URLs in the returned दस्तावेज़। noindex निर्देश खोज से जानबूझकर बाहर रखने का संकेत है, जबकि एक canonical पसंदीदा URL बताता है; वे अलग-अलग समस्याएँ हल करते हैं।
सुधारों को प्राथमिकता दें और सत्यापित करें
चेकलिस्ट: जब कोई टेम्पलेट कई URL पर एक ही समस्या पैदा करता हो, तो प्रतिनिधि पेजों का मैन्युअल निरीक्षण करें। हर रेंडर किए गए पेज को संपादित करने के बजाय टेम्पलेट ठीक करना अधिक प्रभावी हो सकता है।
चेकलिस्ट: टूटे हुए लिंक को उनके रेफ़रिंग पेज और लक्ष्य के अनुसार समूहित करें। उन लिंक को प्राथमिकता दें जो उपयोगकर्ताओं या क्रॉलर को महत्वपूर्ण सामग्री तक पहुँचने से रोकते हैं।
ऑडिट का दायरा तय करें
स्थिति और इंडेक्स होने की पात्रता की जांच करें
चेकलिस्ट: आंतरिक गंतव्यों की तुलना पसंदीदा URL सेट से करें। रीडायरेक्ट की शृंखला पर निर्भर रहने के बजाय सीधे canonical पेजों से लिंक करें।
चेकलिस्ट: सीमित क्रॉल में कोई पेज न मिले, तो हो सकता है कि वह क्रॉल के दायरे से बाहर हो। इसकी पुष्टि करें स्वतंत्र रूप से URL की जाँच करने से पहले इसे अनाथ या हटाया गया पेज बताने से पहले।
चेकलिस्ट: शीर्षकों की तलाश करें और ऐसे विवरण जो सटीक रूप से पहचानते हैं हर पेज का उद्देश्य। हर प्रोडक्ट पर एक ही सामान्य कथन दोहराने से उपयोगकर्ताओं की मदद नहीं करता इनके बीच अंतर स्पष्ट करें।
आंतरिक लिंक की समीक्षा करें
चेकलिस्ट: डुप्लिकेट के संभावित पेजों की तुलना उनकी मुख्य सामग्री और आशय के आधार पर करें। तय करें कि उन्हें समेकित करना है, हटाए गए रूट पर रीडायरेक्ट करना है या वास्तव में अलग जानकारी तैयार करनी है।
चेकलिस्ट: आंतरिक लिंक, canonical टैग और साइटमैप में एक ही पसंदीदा URL का उपयोग करें। परस्पर विरोधी संकेतों से इच्छित URL को समझना कठिन हो जाता है।
चेकलिस्ट: उस सबसे सरल संग्रह विधि से शुरुआत करें जो आपको आवश्यक सामग्री उपलब्ध कराती हो। JavaScript पर निर्भर टेम्पलेट के लिए ब्राउज़र की आवश्यकता हो सकती है, लेकिन ब्राउज़र से संग्रह करने की संसाधन आवश्यकताएँ अलग होती हैं।
- क्रॉल संबंधी समस्याओं को प्रकार और प्राथमिकता के आधार पर समूहित करें, फिर सुधार के बाद प्रभावित URL जाँचें।
-
कीवर्ड, सर्च इंजन, स्थान, भाषा और डिवाइस सेट करें। हर ऑब्ज़र्वेशन के साथ इन सेटिंग्स को सुरक्षित रखें, ताकि रैंकिंग की तुलनाएँ एक ही ऑडियंस और बाज़ार का वर्णन करें।
- ऑर्गेनिक सर्च, मैप्स, न्यूज़, इमेज, शॉपिंग और अन्य समर्थित परिणाम प्रकारों पर शोध करें। प्रत्येक endpoint से लौटाए गए फ़ील्ड को समझने के लिए आइटम प्रकारों का उपयोग करें।
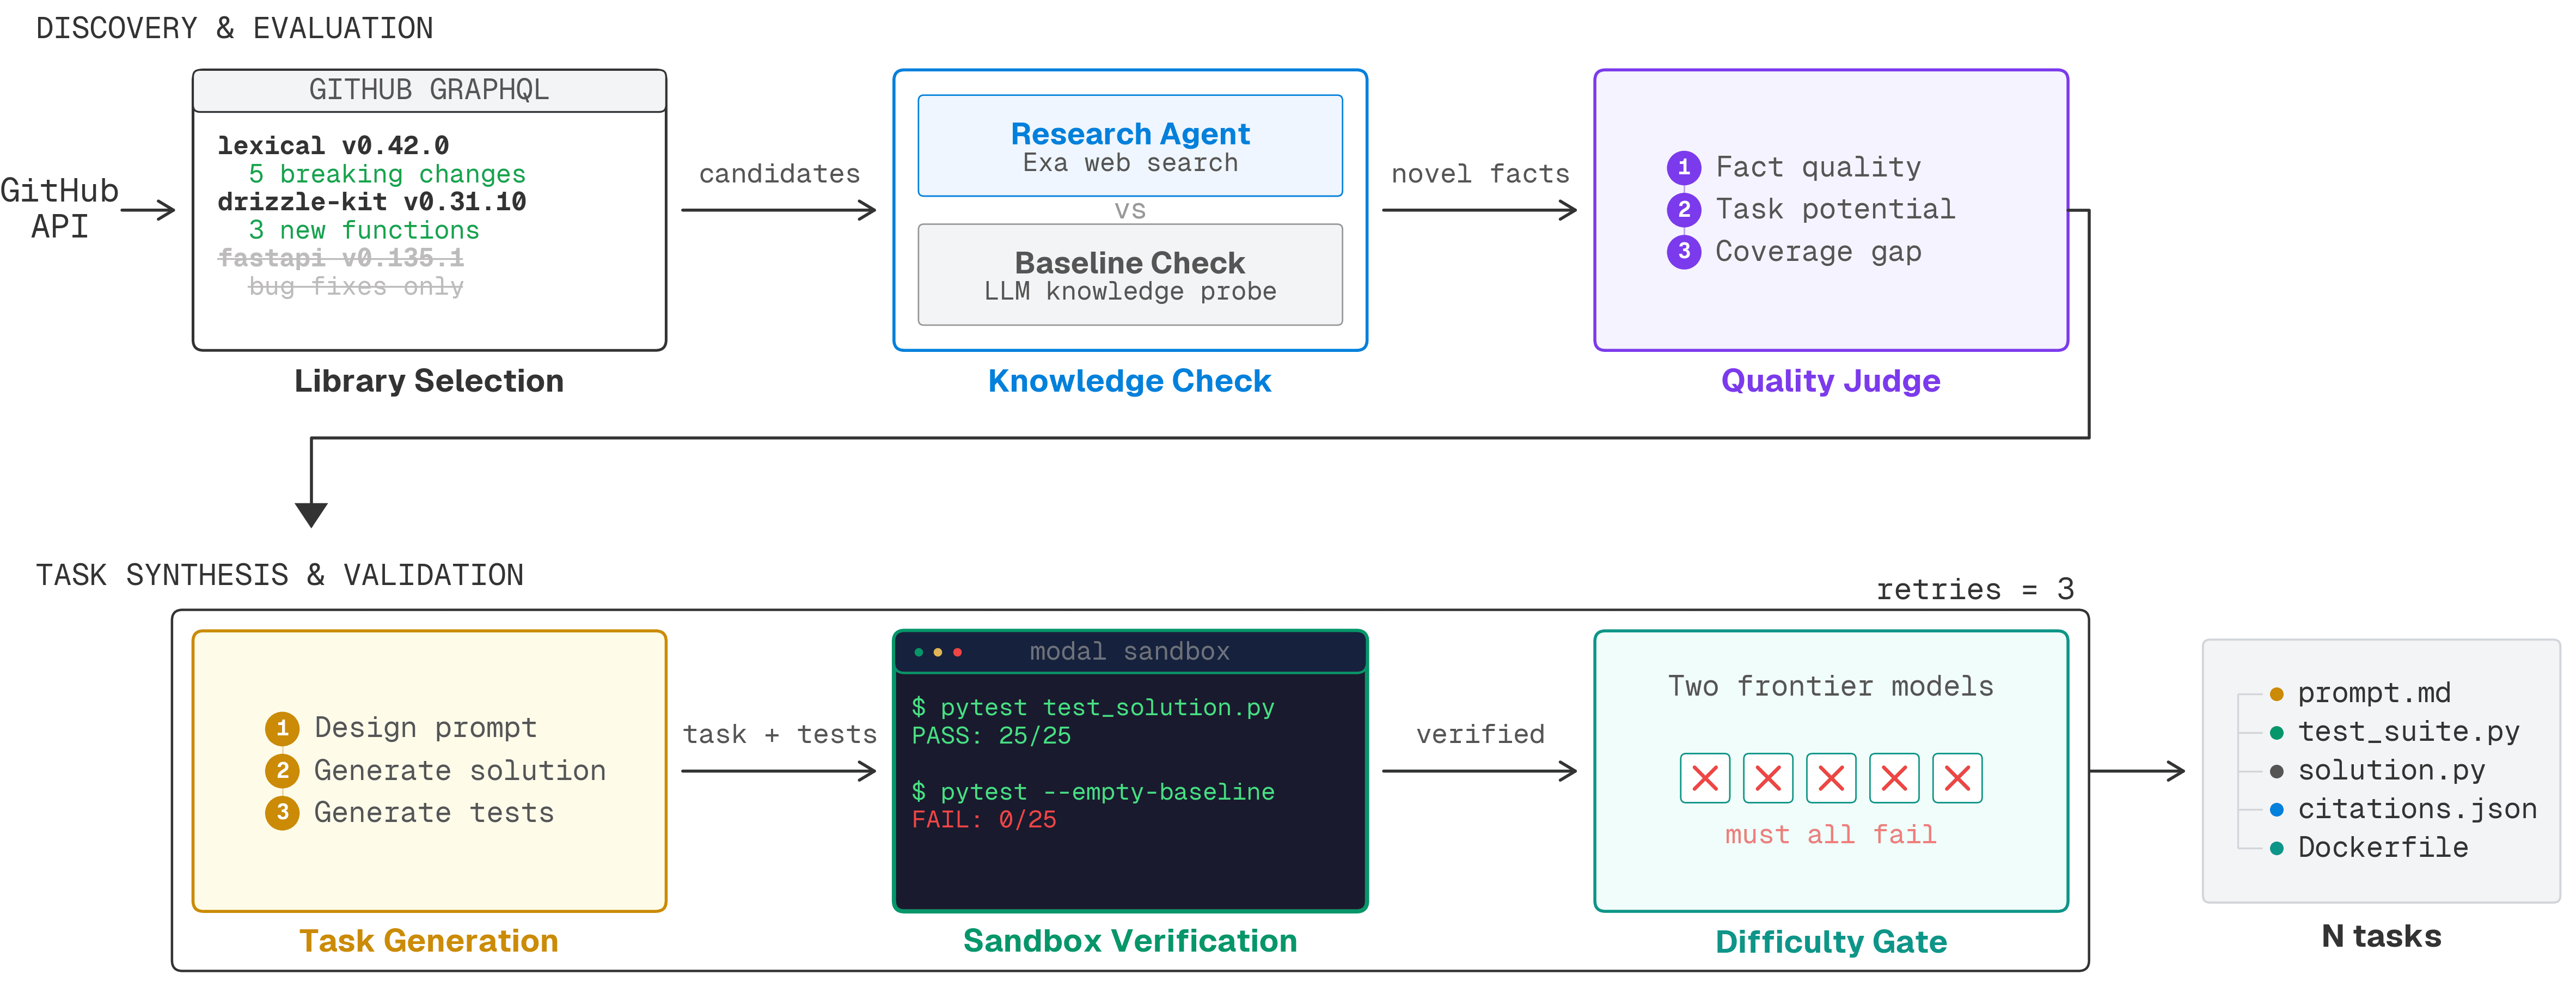
- कार्य निर्माण: नए तथ्यों का उपयोग करके टास्क प्रॉम्प्ट, समाधान और टेस्ट सूट तैयार किया
- नहीं। जिस साइट की आप जाँच कर रहे हैं, उसके लिए रेंडरिंग और ऑडिट विकल्प चुनें। अतिरिक्त प्रोसेसिंग से संग्रह की लागत और गति प्रभावित हो सकती है।
- जिन लक्ष्यों और बाज़ारों की जाँच करनी है, उनसे शुरू करें। हर On-Page API रिस्पॉन्स के साथ स्रोत और डेटा संग्रह का समय रखें।
चेकलिस्ट: Lighthouse को विशिष्ट परिस्थितियों में किए गए लैब परीक्षण के रूप में समझें। फ़ील्ड माप के बिना उसके परिणाम को वास्तविक उपयोगकर्ताओं के Core Web Vitals न बताएं।
चेकलिस्ट: लोड संबंधी समस्याओं की जाँच करते समय इमेज, फ़ॉन्ट और तीसरे पक्ष के संसाधनों की जाँच करें। किसी संसाधन को बदलने के बाद तुलनीय परिस्थितियों में उसी पेज का फिर से परीक्षण करें।
मेटाडेटा और डुप्लिकेशन जाँचें
चेकलिस्ट: हर निष्कर्ष के लिए प्रभावित URL, साक्ष्य, उपयोगकर्ता पर संभावित प्रभाव और ठोस समाधान दर्ज रखें। पुष्ट समस्याओं और आगे जाँच की आवश्यकता वाले सवालों में अंतर करें।
चेकलिस्ट: छोटी-मोटी चीज़ों को बेहतर बनाने से पहले सीधे इंडेक्सिंग और नेविगेशन की विफलताओं को ठीक करें On-Page API देखें → व्यावसायिक महत्त्व, प्रभाव और कार्यान्वयन के प्रयास के आधार पर।
चेकलिस्ट: सुधार के बाद संबंधित जाँचें दोहराएँ और साक्ष्यों की तुलना करें। सफल परीक्षण जाँचे गए व्यवहार को प्रमाणित करता है; यह भविष्य की सर्च रैंकिंग की गारंटी नहीं देता।
खुली भूमिकाएँ देखें-
1
.
व्यवहार में: ग्राहकों के लिए महत्वपूर्ण URL से शुरुआत करें: प्रमुख लैंडिंग पेज, उत्पाद पेज और प्रतिनिधि टेम्पलेट। दर्ज करें कि लक्ष्य क्रॉल करने की क्षमता है, इंडेक्सिंग, कंटेंट की गुणवत्ता या पेज के प्रदर्शन में।
ऑडिट का दायरा तय करें
व्यवहार में: क्रॉल सेटिंग का एक निश्चित समूह और पेज की स्पष्ट सीमा तय करें। समय से पहले रुक जाने वाला क्रॉल यह साबित नहीं कर सकता कि साइट का हर पेज ठीक है।
स्थिति और इंडेक्स होने की पात्रता की जांच करें
व्यवहार में: लक्ष्य, रेंडरिंग विकल्प और संग्रह मार्ग का दिनांकित रिकॉर्ड रखें। इससे बाद की तुलना समझाई जा सकती है, बजाय इसके कि अलग-अलग परिस्थितियों में एकत्र किए गए परिणामों को मिला दिया जाए।
आंतरिक लिंक की समीक्षा करें
व्यवहार में: पेज की सामग्री पढ़ने से पहले HTTP प्रतिक्रिया की समीक्षा करें। रीडायरेक्ट, त्रुटि प्रतिक्रिया या अवरुद्ध अनुरोध की जांच सफल HTML पेज से अलग तरीके से करनी चाहिए।
मेटाडेटा और डुप्लिकेशन जाँचें
व्यवहार में: लौटाए गए दस्तावेज़ में robots मेटा टैग और canonical URL जांचें। noindex निर्देश खोज से जानबूझकर बाहर रखने का संकेत है, जबकि canonical पसंदीदा URL बताता है; दोनों अलग-अलग समस्याओं का समाधान करते हैं।